

Pode ser difícil distinguir uma atividade maliciosa em uma rede industrial da troca de dados normal entre dispositivos. Os invasores recorrem constantemente a ferramentas legítimas e à técnica Living-off-the-Land, por isso uma conexão de rede isolada pode não conter indícios conhecidos de ataque, pois o dispositivo usa um protocolo habitual e transmite dados comuns. A anomalia pode se esconder em detalhes pouco evidentes. A origem dos dados, o horário da solicitação e o volume de informações transmitidas podem ser atípicos para um dispositivo específico. No entanto, para identificar esse tipo de anomalia, é importante entender as funções dos dispositivos nas duas pontas da conexão e saber quais padrões de atividade de rede são característicos deles.
Além disso, os dados de inventário de ativos da empresa costumam estar incompletos, o que dificulta a detecção ágil de conexões não autorizadas. Suponha que o monitoramento detecte um nó que troca dados regularmente com controladores lógicos programáveis (CLPs). O endereço IP dele é conhecido, mas o inventário não informa qual função ele desempenha. É uma estação de engenharia, um servidor de dados de processo ou um equipamento de um prestador de serviços? Além disso, o nó pode estar em operação na rede industrial há muito tempo, e as informações sobre ele podem ter ficado desatualizadas após a modernização da rede.
Nas recomendações conjuntas sobre inventário de ativos OT, publicadas pela CISA e parceiros em 2025, o inventário e a classificação de dispositivos por função são tratados como parte da gestão de ativos OT (Asset Management). Do ponto de vista das empresas, essa é uma das áreas mais importantes: segundo a pesquisa da SANS sobre segurança de sistemas de controle industrial (ICS) em 2025, nos 12 meses anteriores, 50% dos entrevistados implementaram ou ampliaram significativamente as ferramentas de inventário e visibilidade de ICS, e 54% as incluíram entre as prioridades de investimento para os próximos 12 a 24 meses.
Inventário de dispositivos no Kaspersky Industrial CyberSecurity for Networks
No Kaspersky Industrial CyberSecurity for Networks, a base da visibilidade de ativos é a tecnologia Asset Discovery. A análise passiva do tráfego de rede detecta os dispositivos e suas interações, e as regras de reconhecimento ajudam a determinar a categoria do dispositivo e a extrair as informações disponíveis sobre ele, como fabricante, modelo, versão do software etc. Os atributos que podem ser obtidos dependem do protocolo e da troca observada. Falamos sobre isso em detalhes na Kaspersky Industrial Cybersecurity Conference.
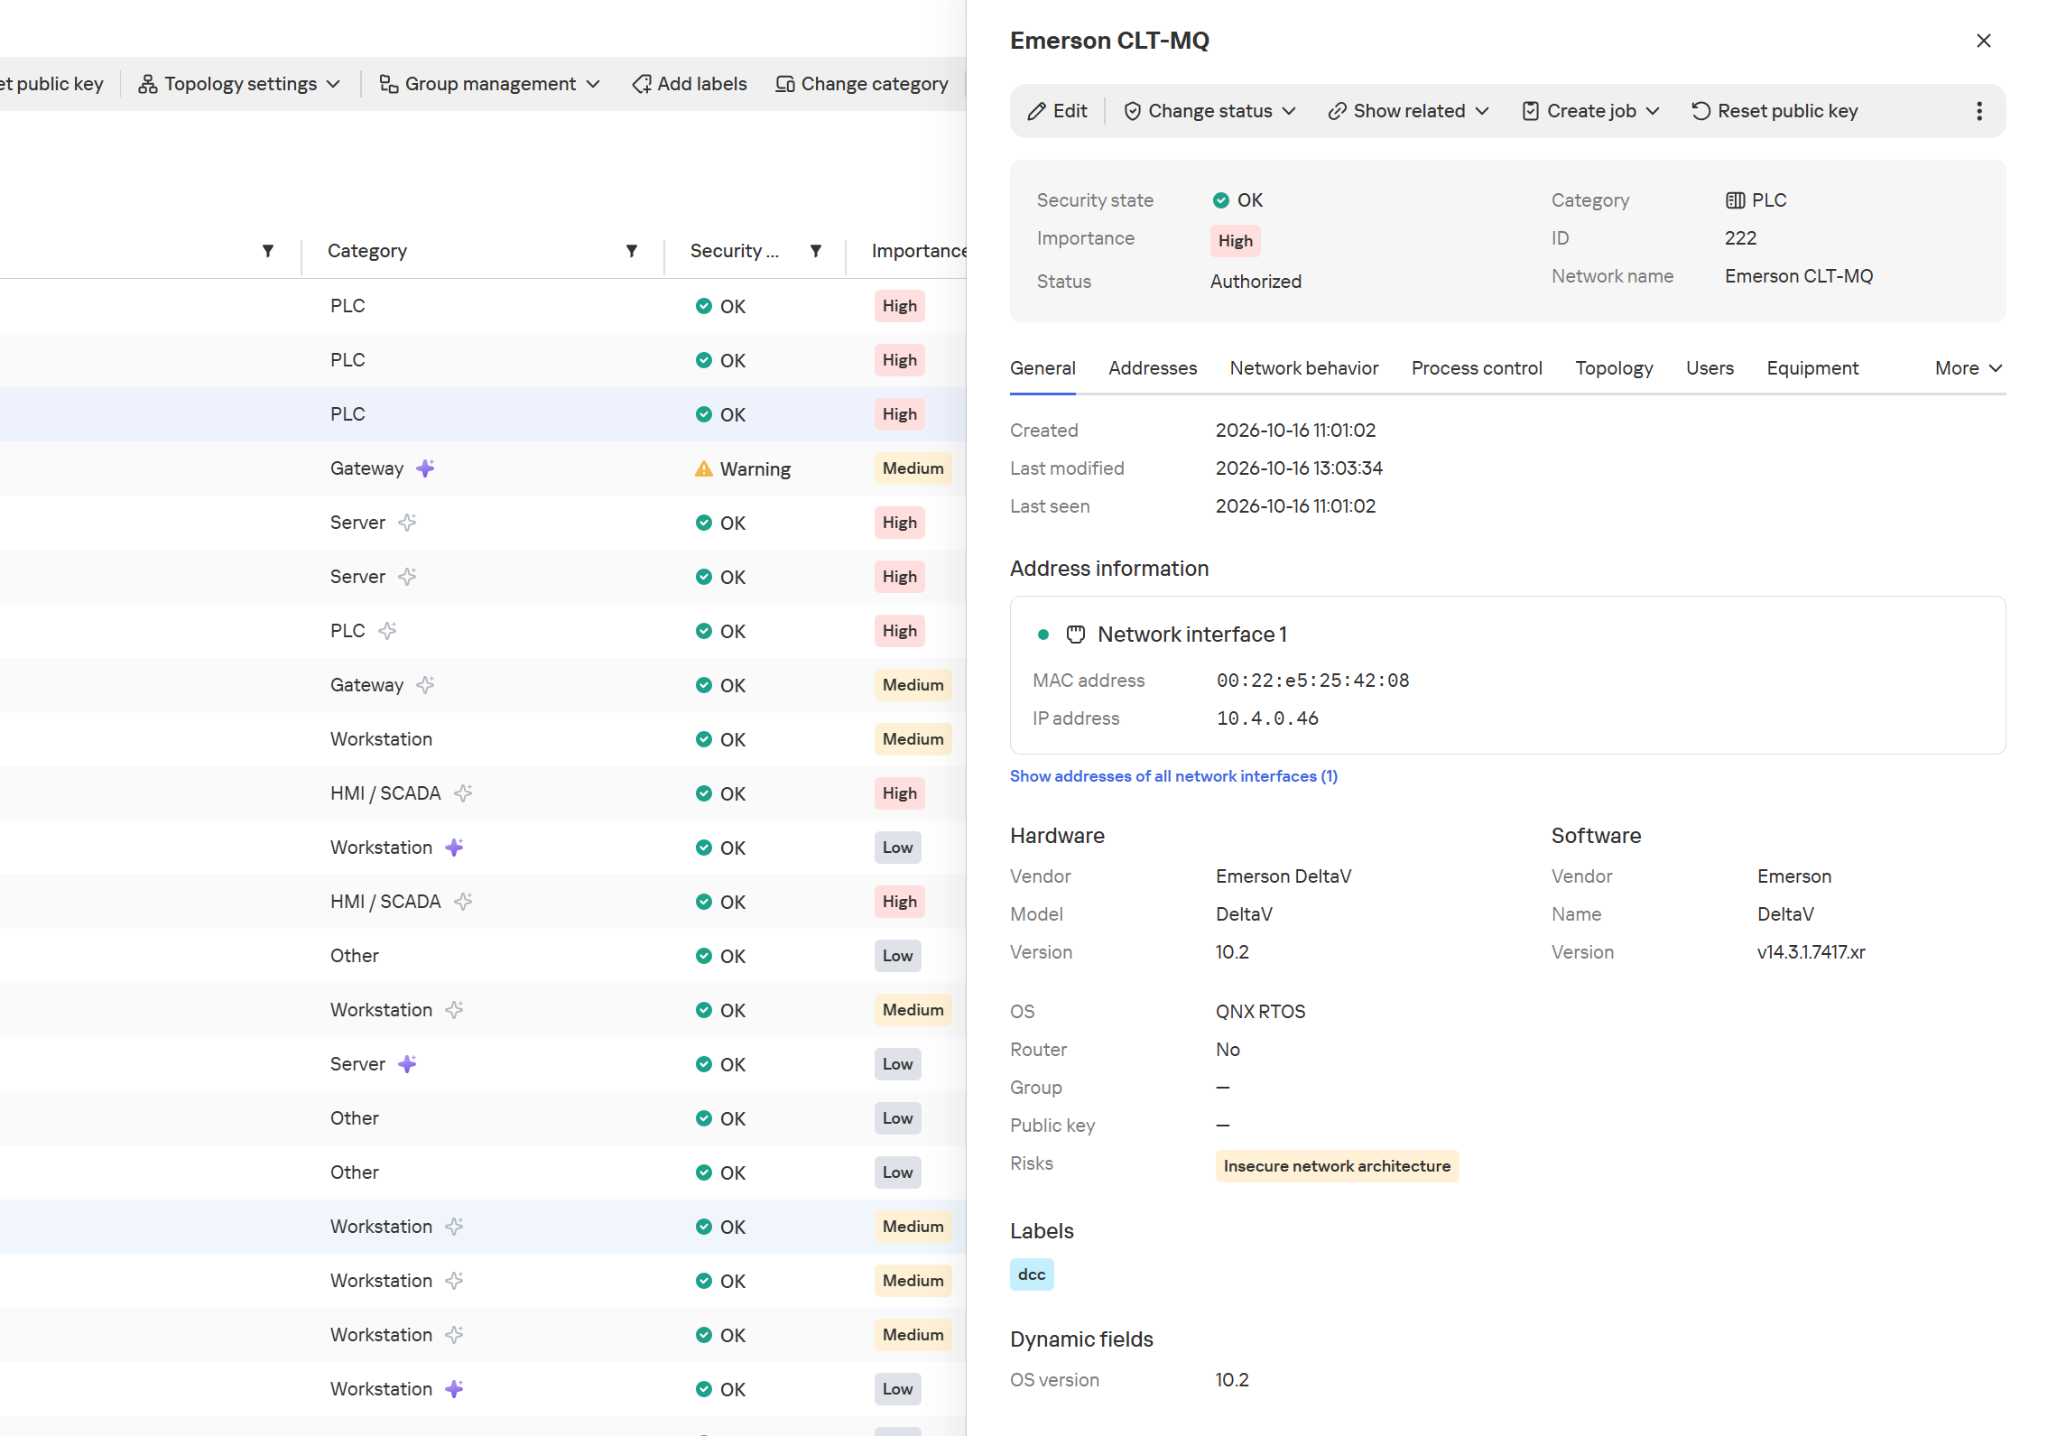
Informações de hardware e software no cartão do dispositivo
Além disso, o produto oferece suporte a módulos de consulta ativa (MCA). Nos casos em que a consulta é permitida, eles podem solicitar aos dispositivos informações adicionais sobre a configuração e a versão do firmware. Esse tipo de inventário é muito mais detalhado do que uma lista de endereços IP.
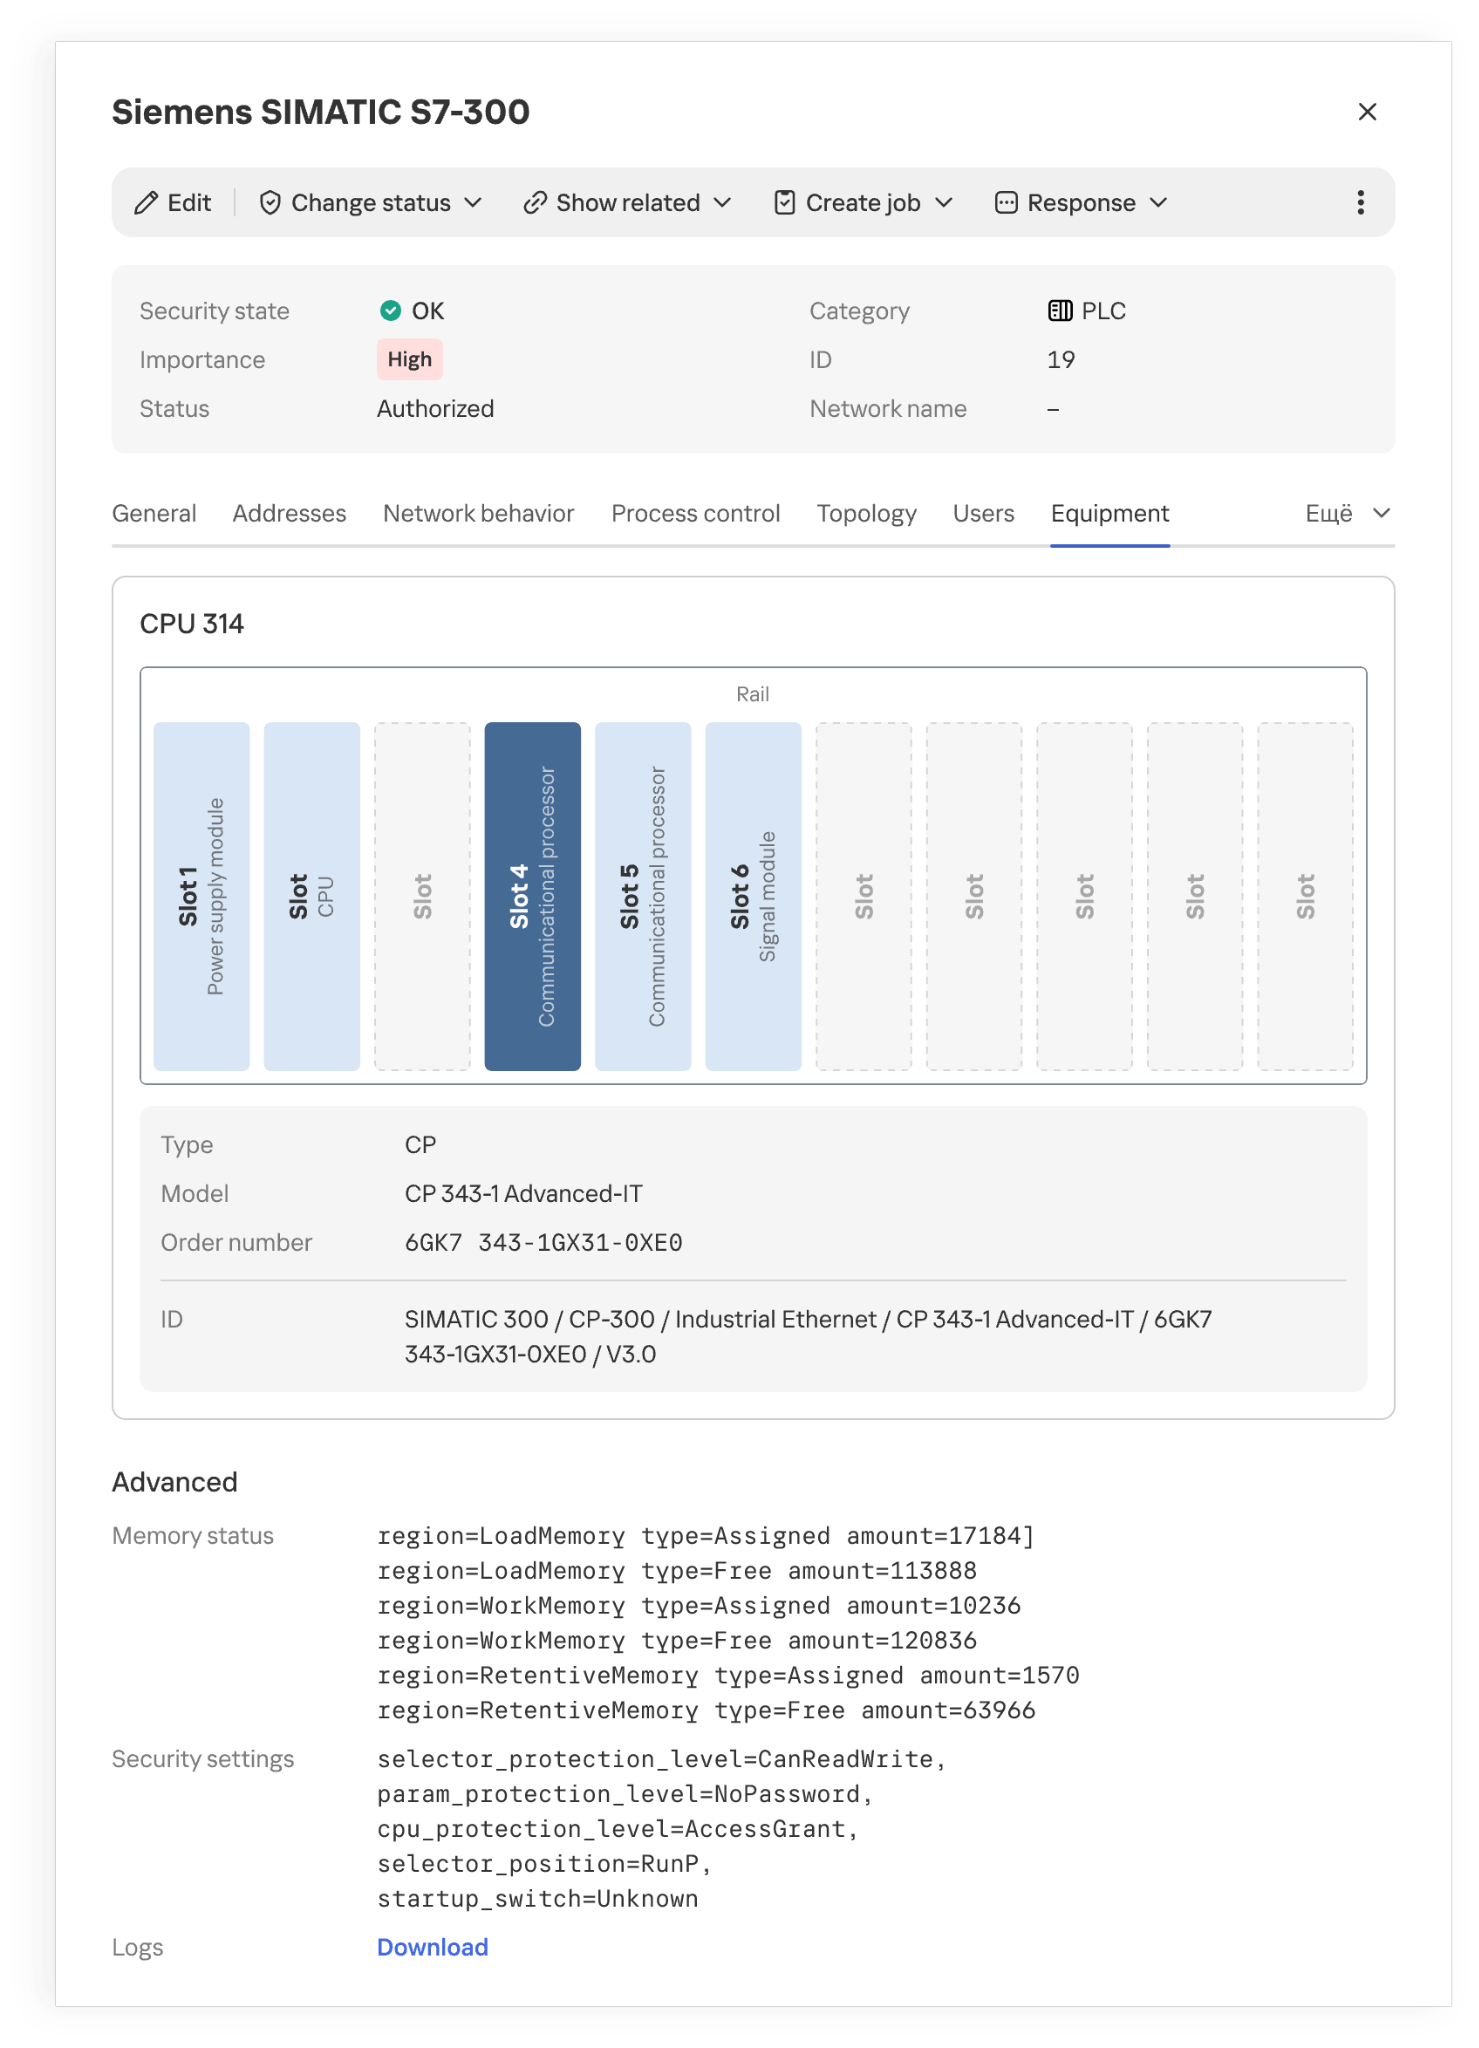
Composição e posição dos módulos no rack do CLP
No entanto, mesmo informações precisas sobre o equipamento nem sempre explicam qual função o nó desempenha em uma instalação industrial específica. As lacunas surgem por diferentes motivos. Alguns dispositivos transmitem informações de identificação apenas na inicialização ou na configuração, outros raramente se comunicam. Nem sempre é possível decodificar um protocolo proprietário, e a criptografia pode deixar para análise apenas os metadados das conexões. Se o tráfego não chegar ao sistema de monitoramento a partir de todos os segmentos da rede industrial, parte da atividade de rede fica fora da observação. A consulta ativa também não se aplica a todos os dispositivos nem a todas as condições de operação.
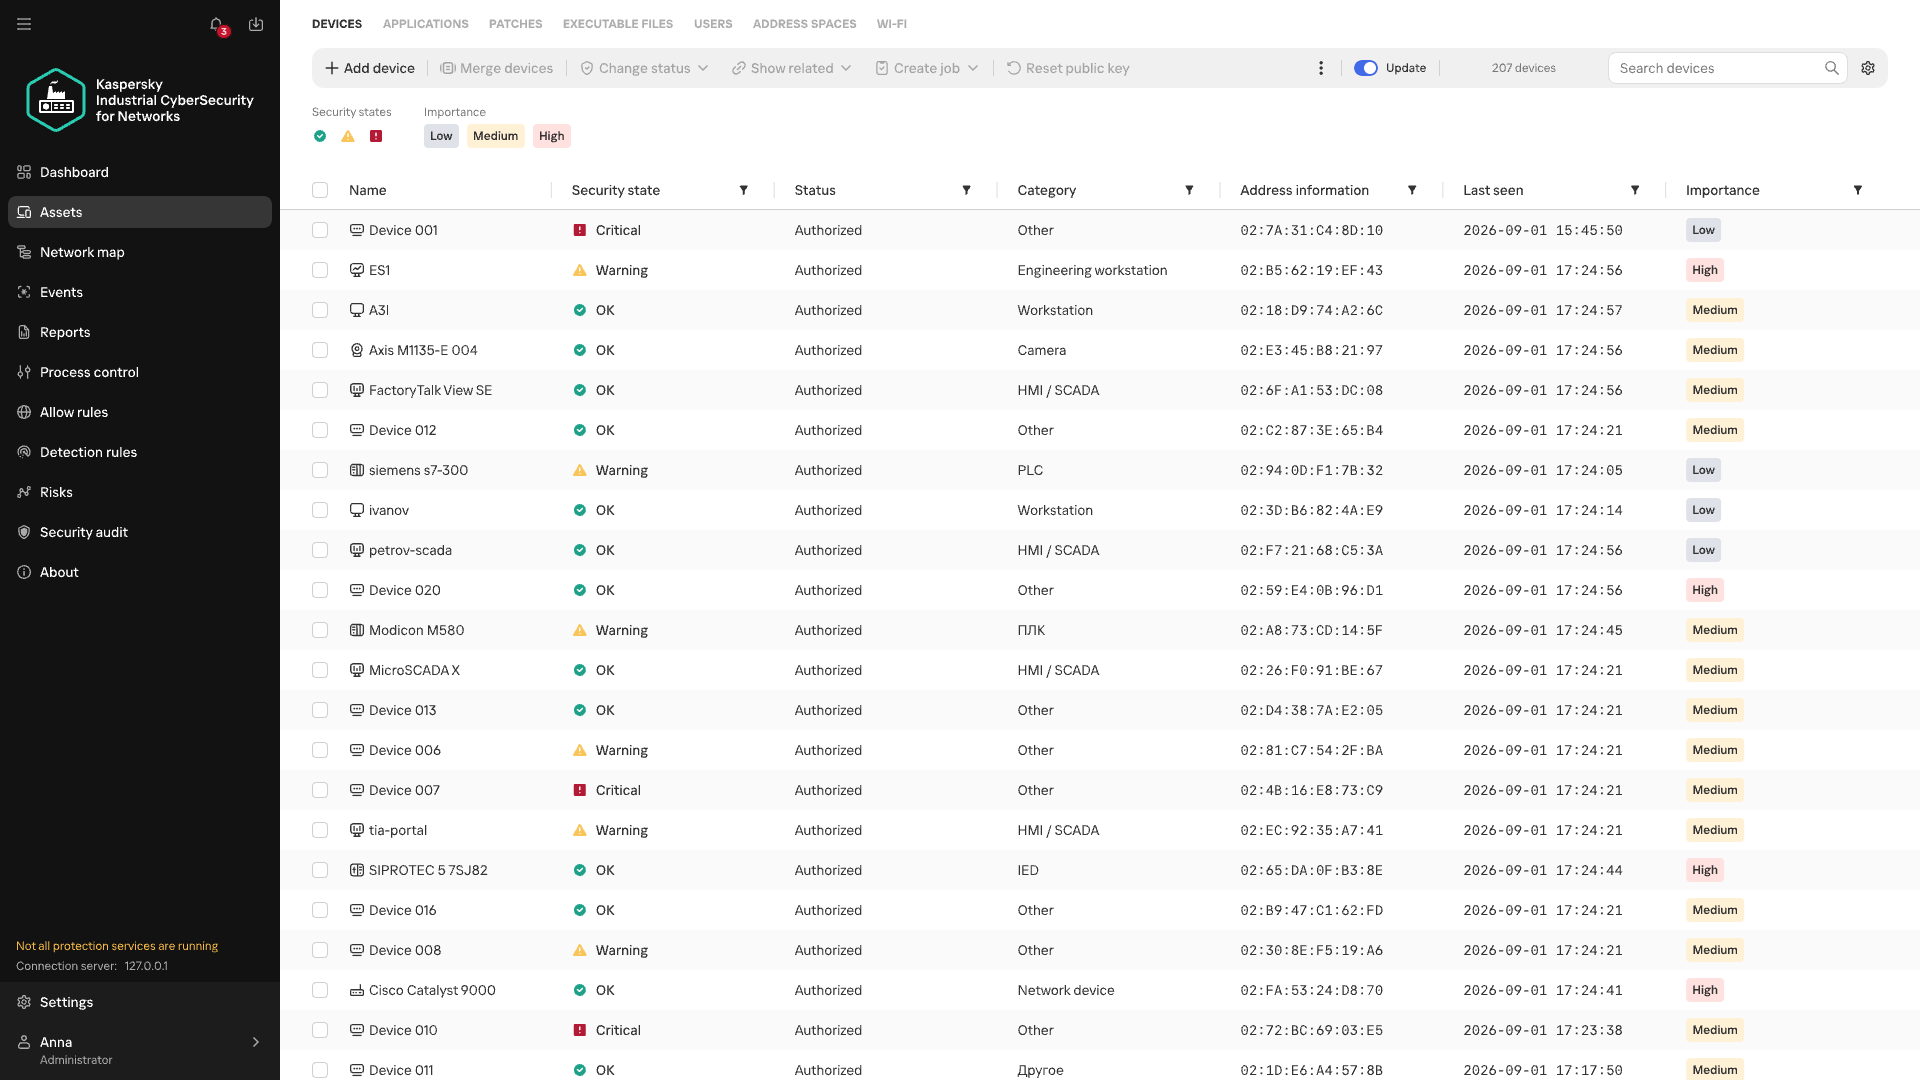
Dispositivos cuja categoria não foi possível determinar
Quando as informações diretas sobre um dispositivo são insuficientes, é possível refinar a categoria dele pela natureza das interações de rede recorrentes. O serviço Machine Learning Event Processor (MLEP), incluído na versão 5.0 do Kaspersky Industrial CyberSecurity, é especializado na análise dessas interações. Trata-se de um processador de eventos baseado em machine learning, que pode ser usado tanto para refinar as categorias de dispositivos quanto para detectar anomalias no comportamento de rede deles.
Quais dados o MLEP usa na análise?
Para comparar o comportamento dos dispositivos, não é necessário armazenar cada pacote como uma observação (observation, objeto de dados) separada no modelo de ML. No MLEP, as sessões de rede são representadas como uma sequência de fragmentos curtos de 15 segundos. Para cada um deles, são armazenadas informações sobre os participantes (IP, MAC, porta) e a direção da troca de dados, o protocolo, a quantidade e o tamanho dos pacotes transmitidos, o que constitui um evento, complementado por um timestamp. Assim, o fluxo de tráfego se transforma em uma sequência de eventos que permite rastrear com quais nós o dispositivo se comunicou, quando isso aconteceu e como variou a intensidade das comunicações.
A agregação dos dados em eventos também define o limite do método. A partir de um fragmento agregado, não é possível reconstruir a ordem exata de cada pacote nem o conteúdo dos comandos. O MLEP só consegue tirar conclusões sobre um novo protocolo se ele tiver sido reconhecido por outra tecnologia do KICS. Por outro lado, para comparar conexões de rede estáveis e mudanças no volume de troca, não é necessário um registro detalhado de cada pacote. Essas observações formam a base do histórico comportamental do dispositivo.
Das observações ao resultado do MLEP
O histórico comportamental é individual para cada objeto. Não é possível aplicar a um objeto o histórico de outros. Mas é possível usar, em objetos diferentes, os mesmos princípios de análise de comportamento e algumas regras comuns.
Explicaremos como isso funciona no MLEP, que se baseia em uma rede neurossemântica de pulsos (NSN).
Identificação de eventos
Nas redes neurossemânticas, as informações são estruturadas como um grafo ordenado de várias camadas, em que os dados de cada camada se baseiam nos dados da camada anterior. Os nós desse grafo, ou seja, as unidades de informação de cada camada, atuam como neurônios.
Para trabalhar com diferentes parâmetros de eventos (porta, IP etc.), a NSN cria os canais correspondentes. Os valores únicos dos parâmetros de cada canal são armazenados como neurônios da camada zero. O próprio evento, formado por um conjunto de valores de parâmetros, é armazenado como um neurônio na primeira camada da rede. Se o evento ocorrer pela primeira vez, a neurogênese cria um novo neurônio, com conexões de entrada para os neurônios de parâmetros correspondentes. Isso permite que a rede aprenda e, ao mesmo tempo, processe o fluxo de eventos em tempo real. Se o evento não ocorrer pela primeira vez, é ativado exatamente o neurônio criado quando ele apareceu pela primeira vez. Dessa forma, a rede identifica cada evento com precisão. Além disso, cada neurônio correspondente a um evento acumula estatísticas básicas: quando foi ativado pela última vez e quantas vezes foi ativado.
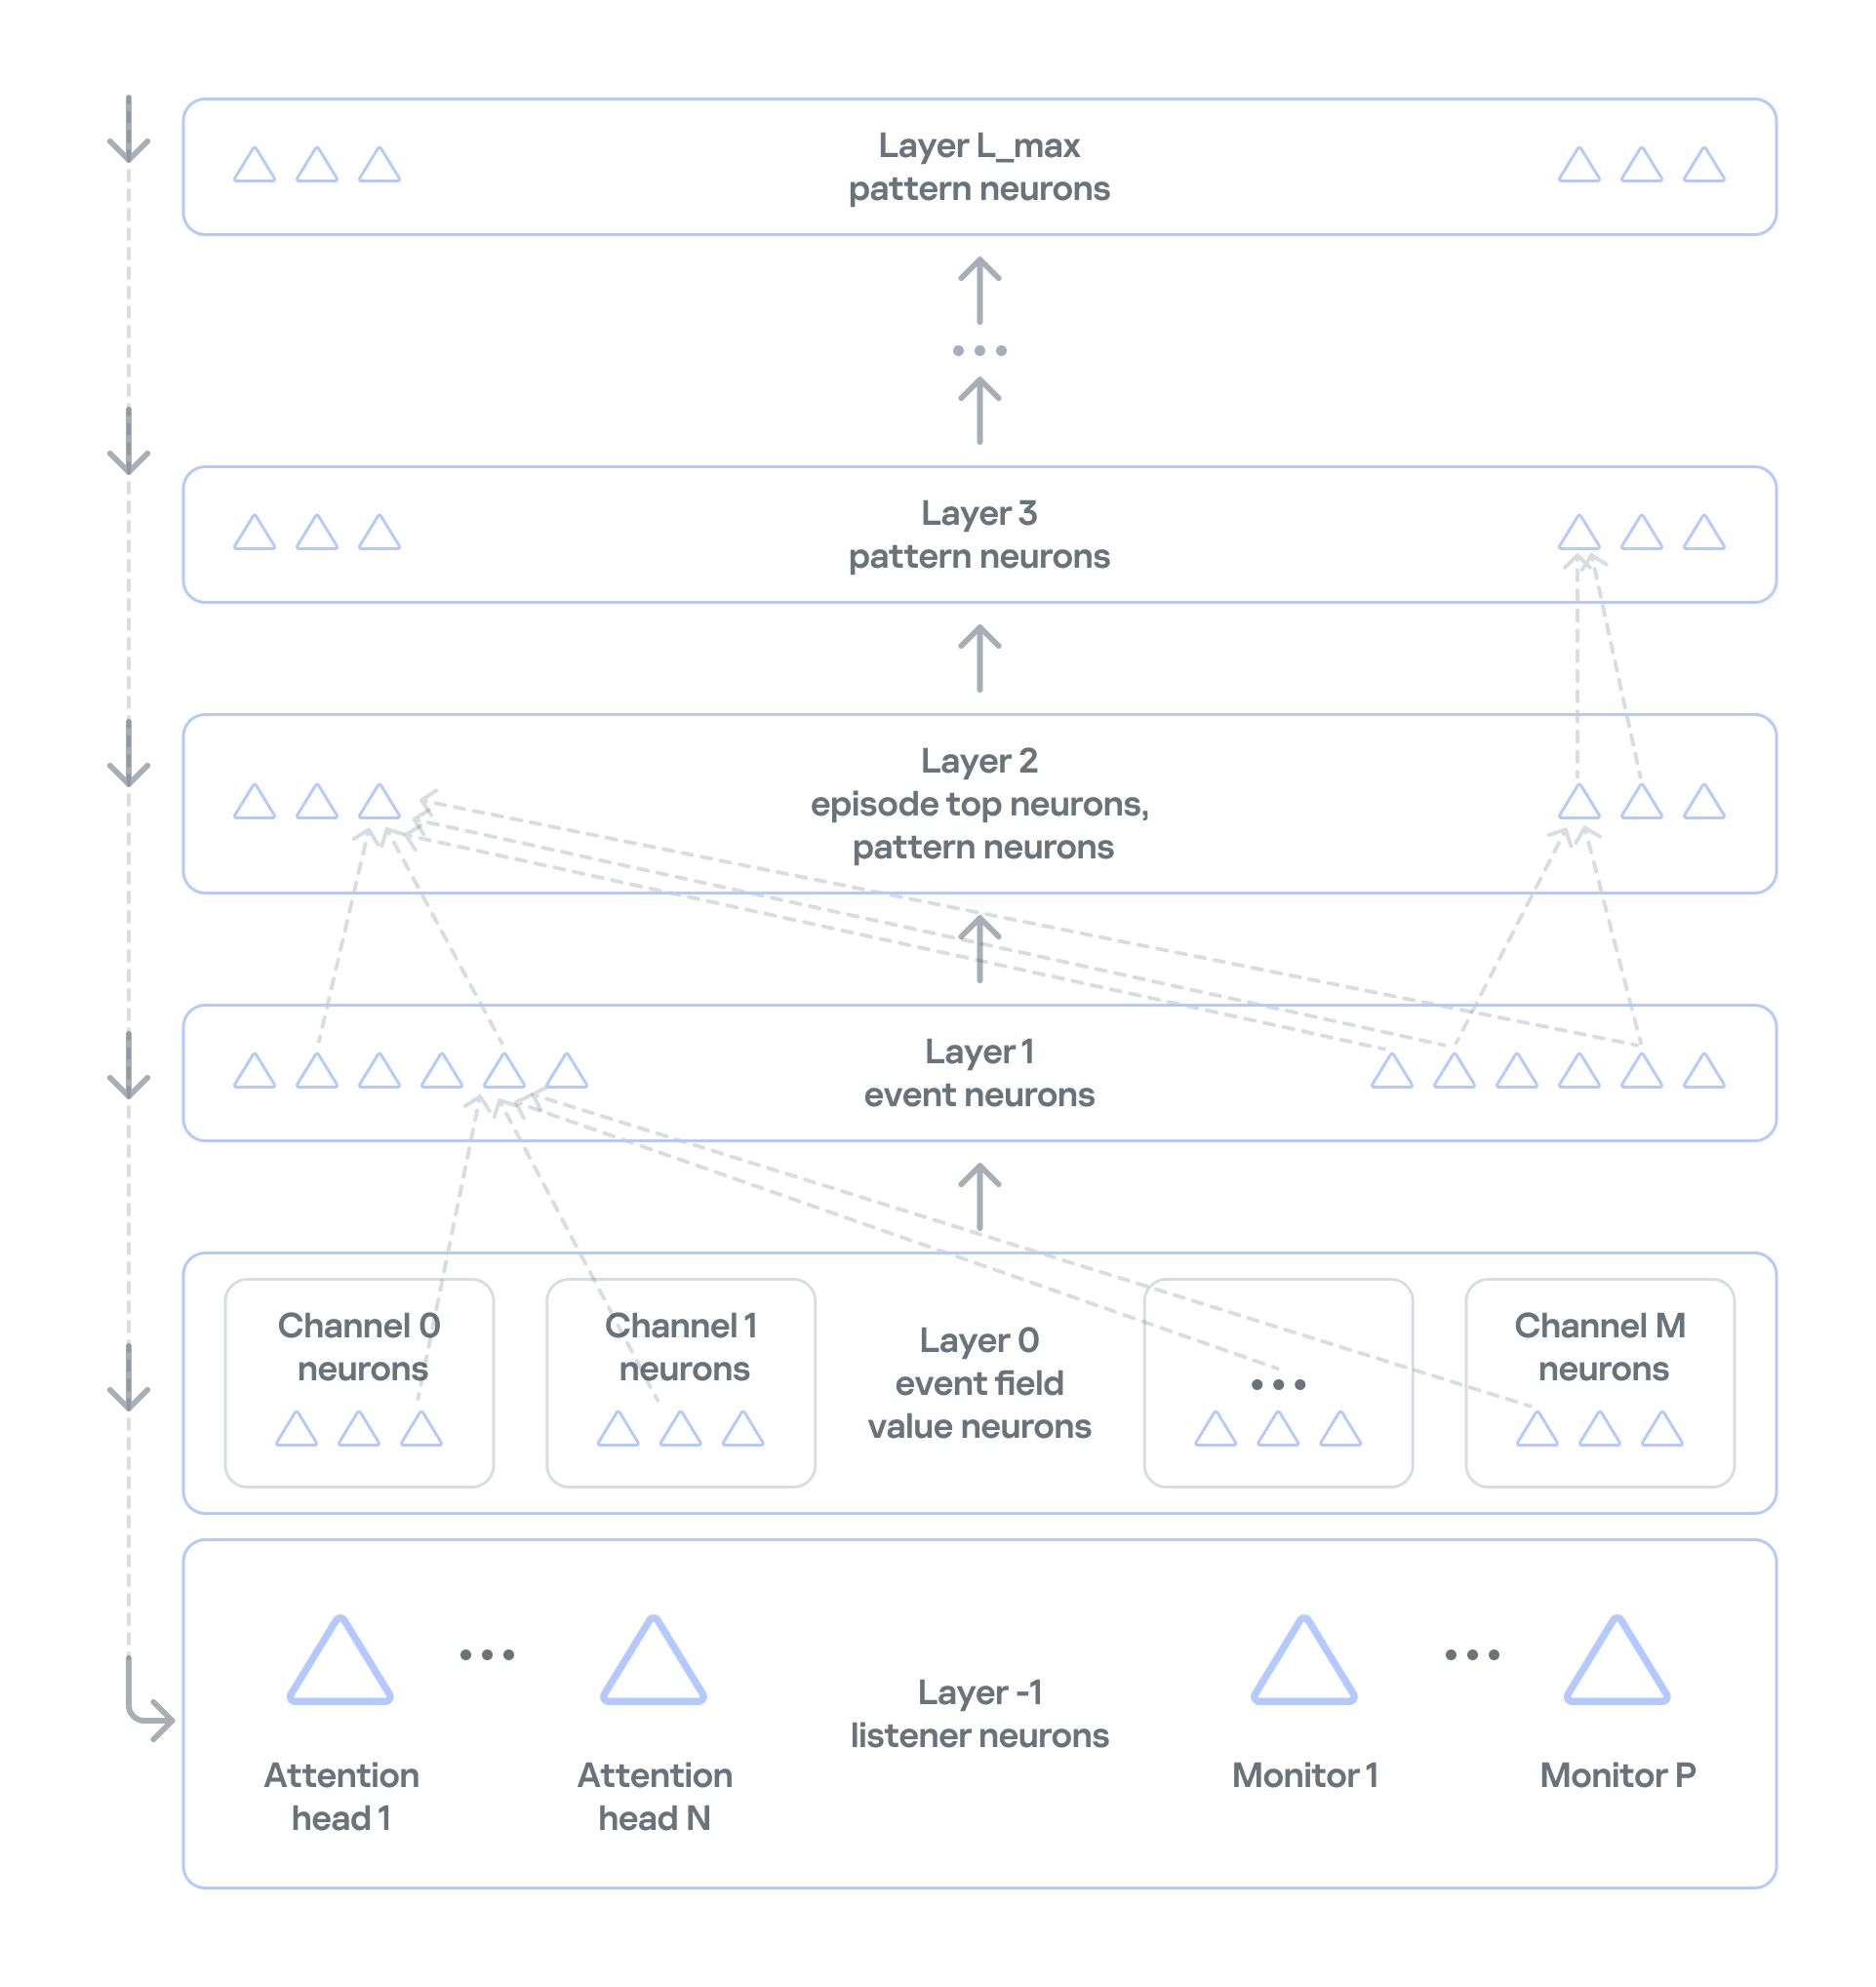
Histórico de eventos
Nas tarefas de processamento de eventos com NSN, o armazenamento de sequências de eventos ao longo do tempo (padrões recorrentes e todo o histórico) ocorre nas camadas seguintes da rede (segunda e superiores). No entanto, para categorizar dispositivos e detectar anomalias estatísticas, não é necessário armazenar a sequência completa de pacotes nem a cronologia detalhada de cada evento de rede. Como já mencionamos, os próprios eventos são agregados, ou seja, a ordem dos pacotes de rede já se perde na média. Por isso, o MLEP usa apenas o armazenamento temporário do histórico dentro de cada episódio (por padrão, um episódio inclui 30 mil agregados), o que permite economizar recursos computacionais.
Processamento de estatísticas no MLEP
A base do mecanismo de processamento de estatísticas do MLEP são os neurônios ouvintes especializados na camada -1 (menos um) da rede. As cabeças de atenção e os monitores funcionam com base nesses neurônios.
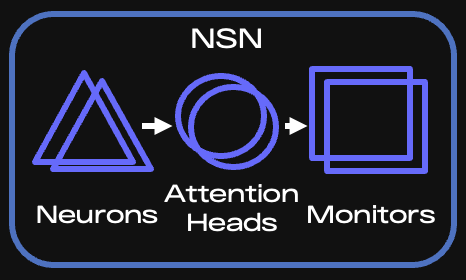
Principais componentes da rede neurossemântica NSN
Quando chega um novo evento, o neurônio correspondente é ativado, e a rede “sabe” imediatamente se é um neurônio novo ou a ativação de um neurônio criado anteriormente. Cada cabeça de atenção se inscreve nos eventos ou nas características de eventos de que precisa e recebe como entrada apenas as ativações dos neurônios correspondentes. Se o evento ocorrer pela primeira vez, todas as cabeças recebem notificações e decidem se precisam se inscrever (criar uma conexão com o neurônio necessário) para receber, a partir daí, informações sobre a ativação desses neurônios.
A rede é chamada de rede de pulsos porque a informação sobre a ativação é um pulso, e não um número. Esse pulso “informa” à cabeça que aconteceu algo de interesse para ela.
A configuração da cabeça de atenção se baseia em cenários, ou seja, nas situações sobre as quais o MLEP deve enviar alertas. A base da configuração da cabeça é a consulta (query), que filtra as informações de entrada e serve como critério de inscrição. A diferença em relação às consultas comuns a um banco de dados é que a consulta é executada em fluxo, o que permite reagir a um evento instantaneamente.
As cabeças de atenção funcionam de forma muito parecida com a semântica da linguagem humana comum. A consulta tem um objeto de atenção (um ou mais sujeitos) e condições (os demais termos da oração). No contexto da infraestrutura da empresa, os “sujeitos” são os dispositivos da rede, e as condições são diferentes aspectos da interação de rede, como portas, protocolo e tamanho médio do pacote. Se houver muitos “sujeitos” (por exemplo, a cabeça se “interessa” por todos os dispositivos da rede industrial), ela cria uma cabeça-filha (fan-out) para cada valor individual do objeto de atenção (para cada dispositivo). A cabeça-filha então “monitora” um dispositivo específico e informa a cabeça-pai.
As cabeças de atenção não acumulam nem processam estatísticas. Elas apenas filtram os fluxos de eventos. Quando a cabeça de atenção recebe o evento necessário, ela própria é ativada e envia um pulso (spike) ao monitor inscrito nela.
Os monitores, por sua vez, têm pilhas para acumular e processar eventos. Além disso, podem ter suas próprias consultas e “refinar o filtro” das informações recebidas da cabeça. Por exemplo, selecionar apenas os eventos novos entre os filtrados pela cabeça.
Há diferentes tipos de monitores:
- Monitores estatísticos, que reagem a mudanças nos valores médios da quantidade de determinados eventos (por exemplo, a atividade dos dispositivos) nos intervalos de tempo característicos desses eventos, ou a mudanças nos valores médios de parâmetros numéricos dos eventos (por exemplo, como varia o volume de tráfego dos dispositivos).
- Monitores para os quais basta a informação do próprio evento, ou seja, que ele ocorreu certo número de vezes em um determinado intervalo de tempo ou pela primeira vez.
- Monitores de comportamento semelhante, que trabalham com cabeças capazes de generalizar eventos, ou seja, extrair deles apenas alguns parâmetros cuja combinação será comum (generalized) a muitos eventos.
Com esses tipos de monitores, o MLEP implementa cenários para categorizar dispositivos e identificar comportamentos anômalos:
- Para a categorização, o MLEP usa cabeças de atenção e monitores que identificam comportamentos comuns em diferentes ativos e, assim, formam grupos de dispositivos. Em seguida, usando as informações do Asset Discovery sobre as categorias conhecidas de alguns ativos, o MLEP estende essas categorias a outros ativos do mesmo grupo. Como um dispositivo pode apresentar diferentes tipos de atividade, ele pode entrar em vários grupos, e, nesse caso, é feita uma avaliação ponderada de todos os grupos relevantes.
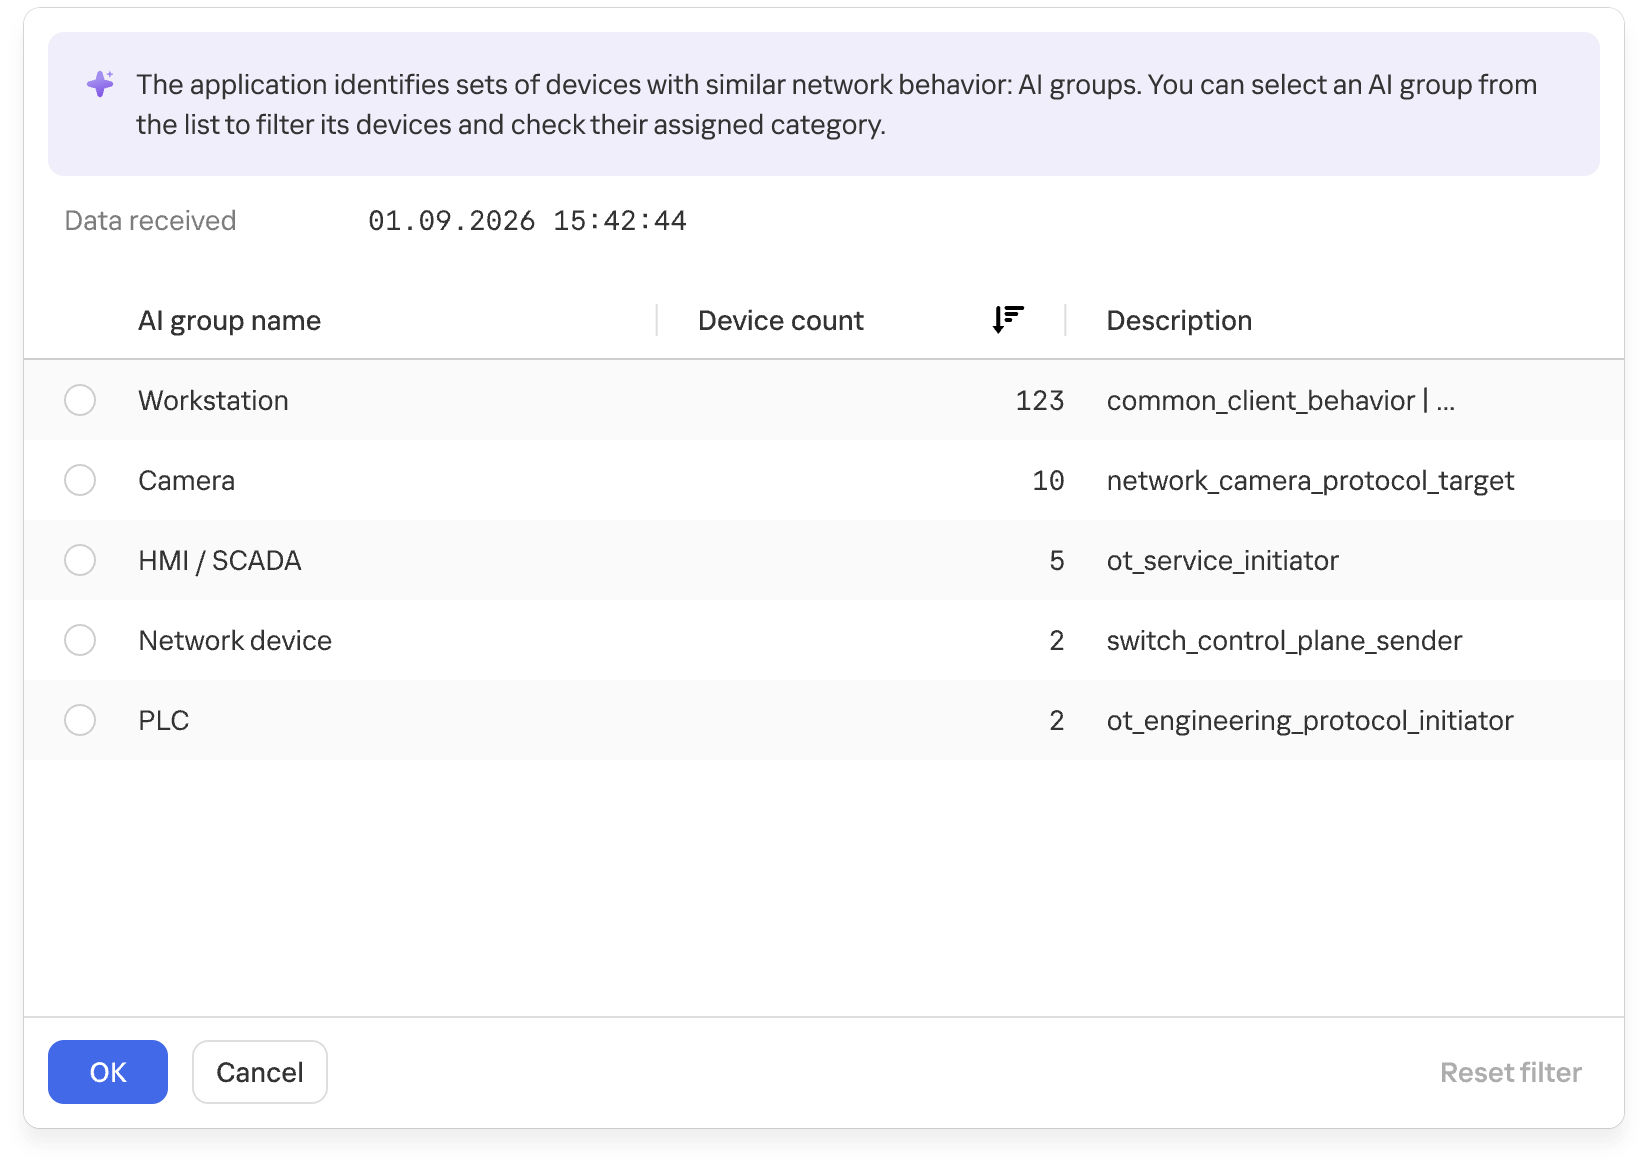
Grupos de dispositivos com comportamento de rede semelhante
No estágio final, verifica-se se é admissível atribuir a categoria ao ativo, o que também é feito por meio de monitores-regras especiais, carregados na NSN na inicialização do sistema. As regras funcionam com base nos metadados do ativo disponíveis no Asset Discovery e nos MCA. - Para detectar anomalias, o MLEP usa um esquema semelhante, em que a cabeça de atenção e o monitor definem, muitas vezes de forma difusa, um cenário de anomalia. Quando o monitor é ativado em resposta a esse cenário, o MLEP gera um alerta de comportamento incomum.
A versão atual do MLEP é fornecida com cabeças e monitores pré-configurados.
O esquema funcional dinâmico do processamento de eventos dos dispositivos na rede industrial é apresentado abaixo.
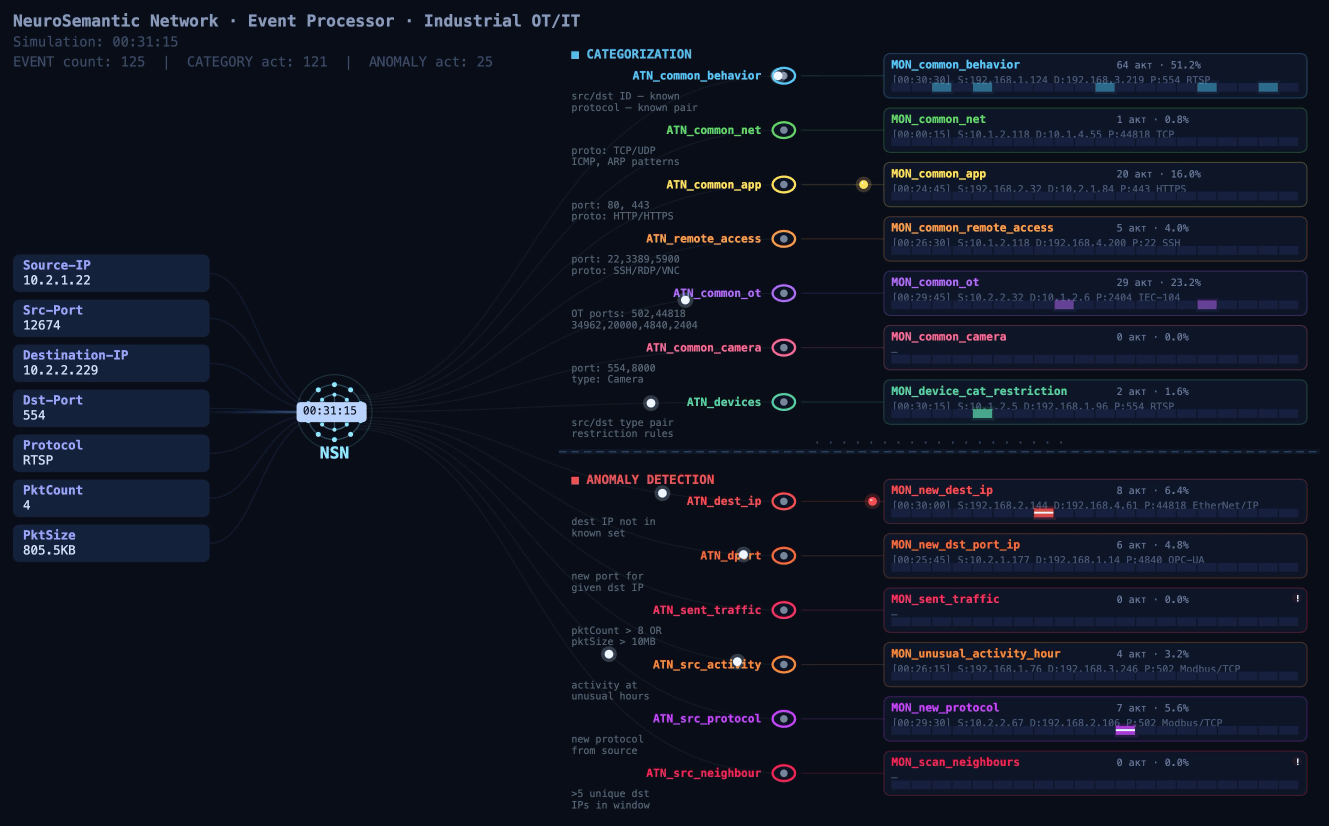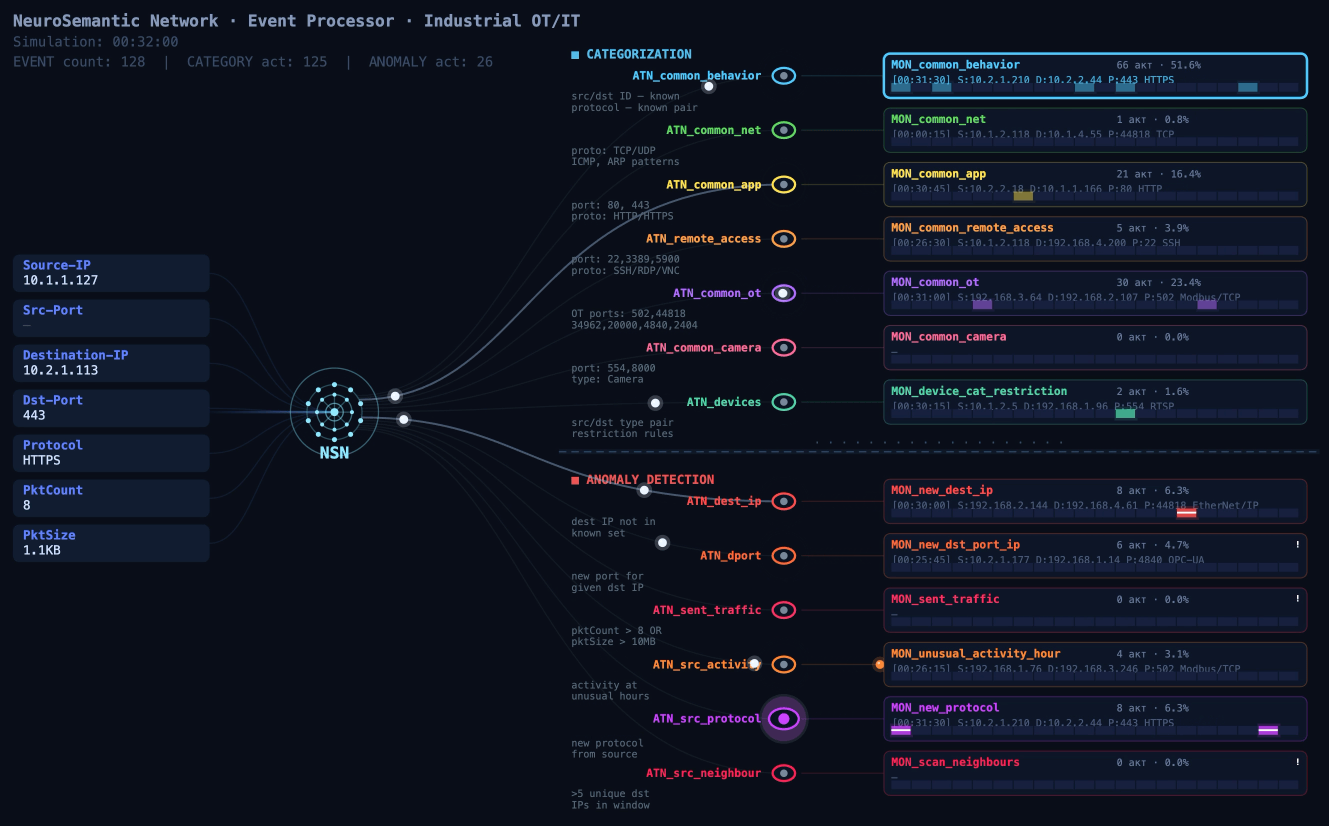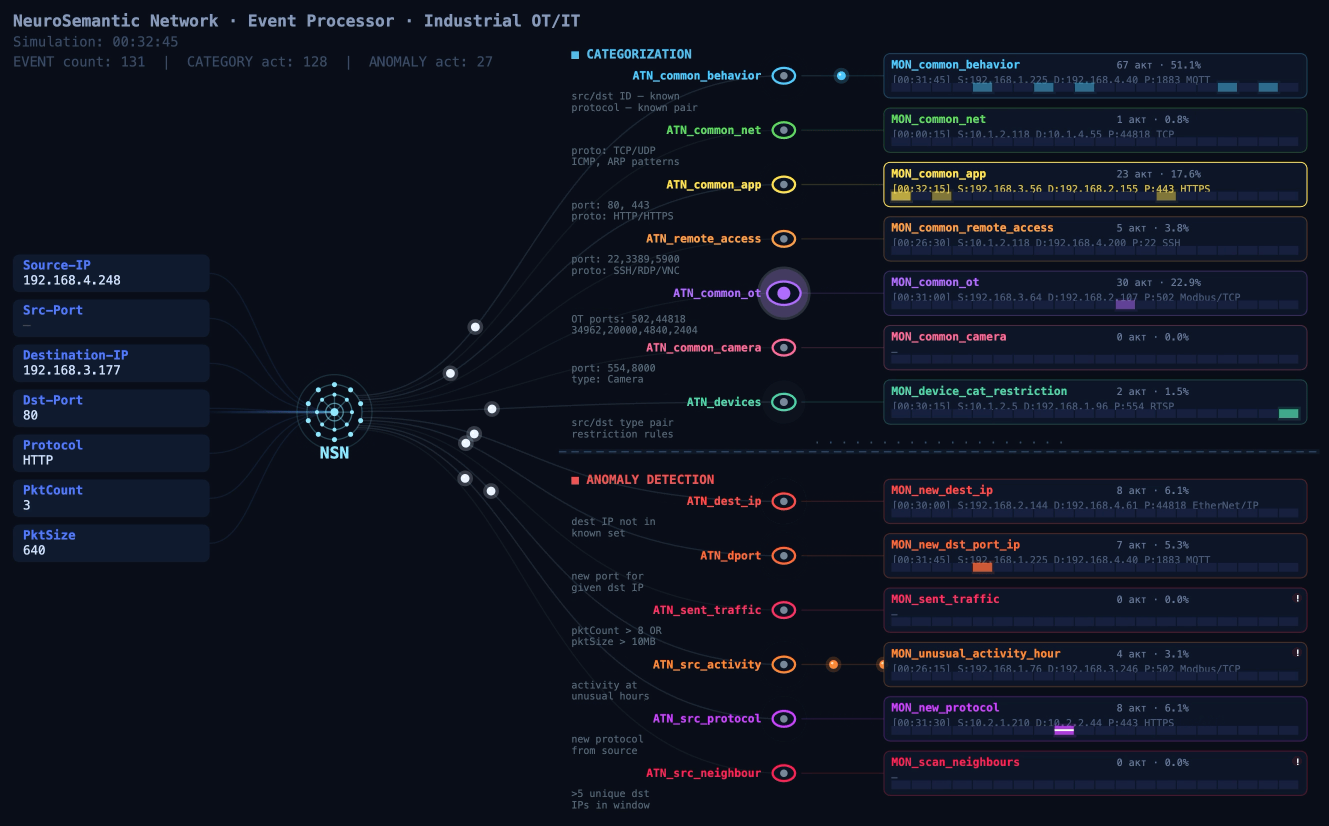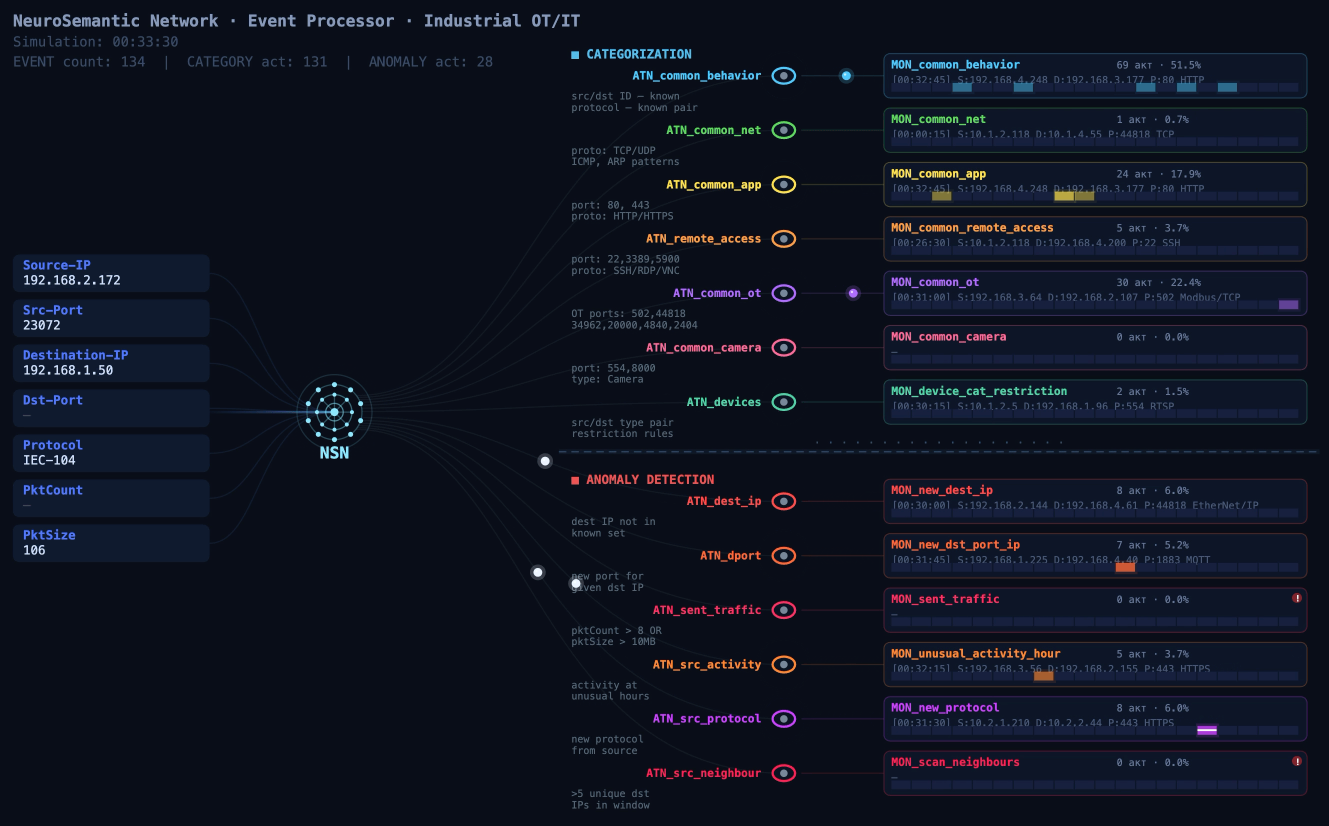
Esquema de processamento de eventos no MLEP
O MLEP na prática: como o comportamento ajuda a complementar o inventário
Em uma empresa com várias linhas de produção do mesmo tipo, o nível de detalhe das informações sobre os dispositivos pode variar de uma linha para outra. Em uma linha, os dispositivos estão identificados como CLPs, enquanto em outra, após a modernização, parte dos nós aparece apenas pelos endereços. As informações do tráfego disponível não foram suficientes para determinar a categoria. Mesmo assim, os dispositivos trocam dados com os mesmos tipos de IHM e de servidores de coleta de dados de processo. As direções, a periodicidade e os volumes das comunicações podem ser semelhantes.
É exatamente aqui que o MLEP ajuda. Ele usa as categorias dos ativos já conhecidos e compara as características recorrentes do comportamento de rede deles com as características dos dispositivos sem categoria. Quando as interações observadas são semelhantes, o MLEP pode complementar o inventário com a categorização desse nó.
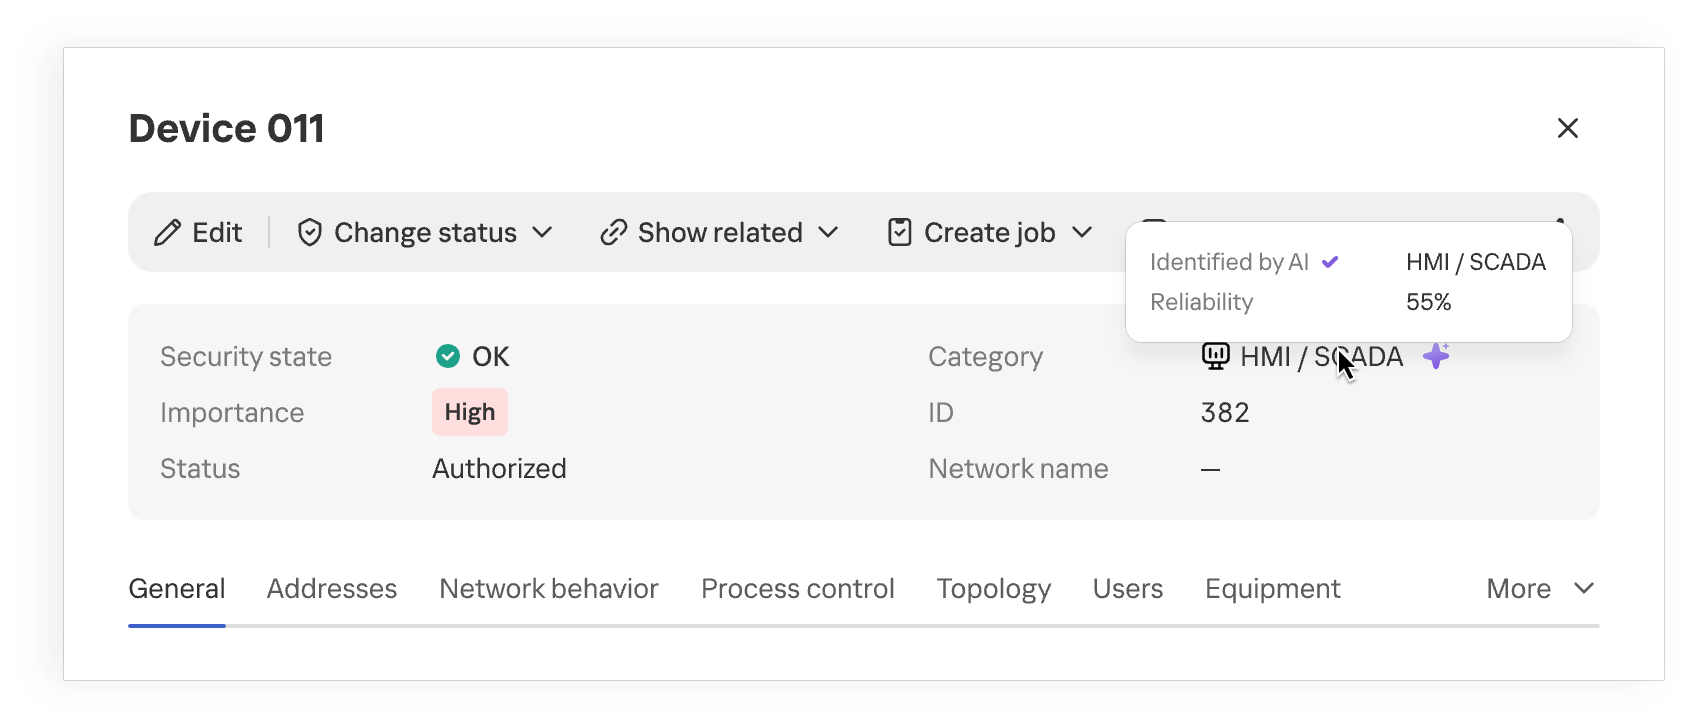
Categoria de dispositivo sugerida pelo MLEP
Depois que a categoria é refinada, o mapa da rede industrial oferece mais contexto sobre os equipamentos que a compõem. Ao analisar a atividade de rede, o analista recebe imediatamente informações sobre a categoria presumida do dispositivo e não precisa procurar a descrição de cada endereço IP nos diagramas do projeto. Esse método é particularmente útil quando a composição dos equipamentos muda mais rápido do que a documentação é atualizada.
A categoria sugerida também é verificada quanto à compatibilidade com as informações já conhecidas sobre o dispositivo e com as restrições definidas. Isso permite descartar parte das opções contraditórias, mas a qualidade da previsão continua dependendo de quão completa é a visibilidade do tráfego, especialmente se o dispositivo se comunicar raramente.
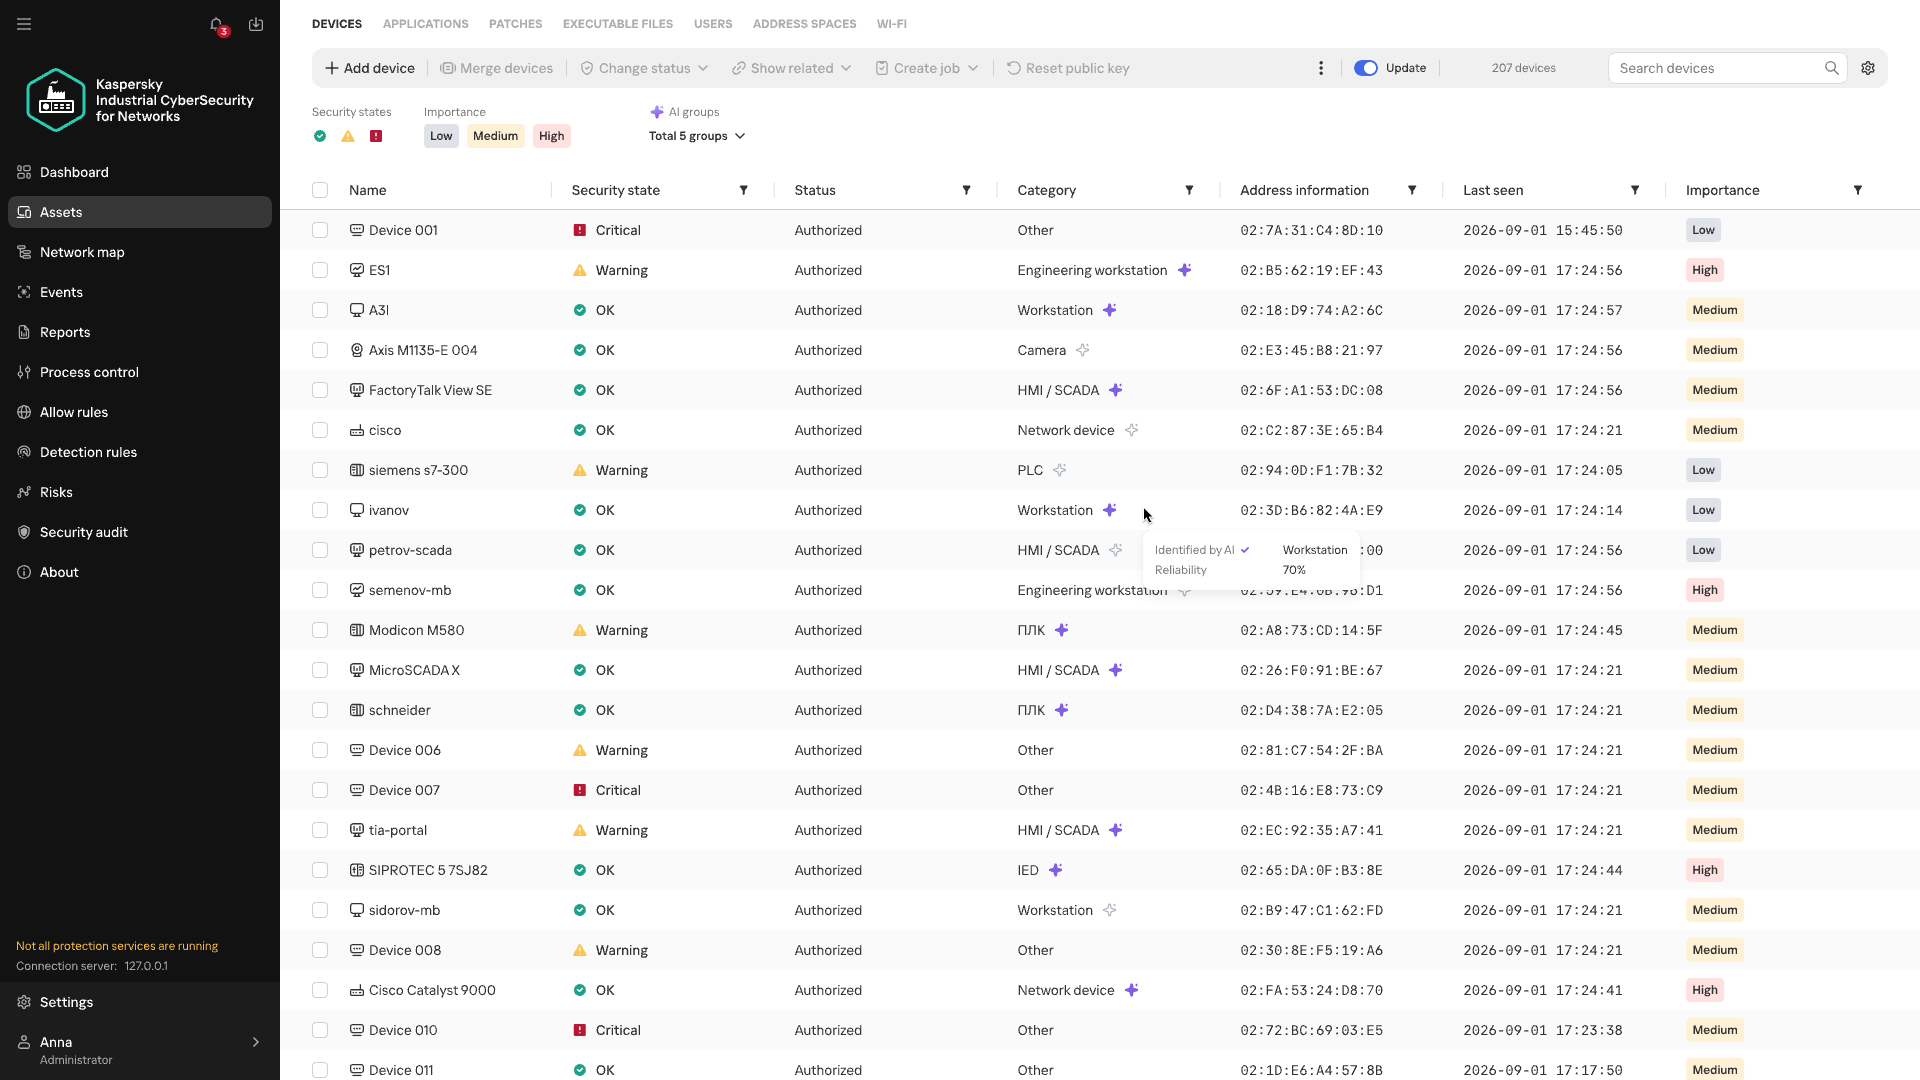
Exibição das sugestões do MLEP na lista de dispositivos
Atividade anômala e estatísticas em fluxo
As investigações de ataques reais mostram que os invasores usam ativamente tanto ferramentas padrão quanto protocolos permitidos. Para perceber uma atividade potencialmente maliciosa, nem sempre é preciso conhecer de antemão a técnica específica do invasor. Os métodos de detecção baseados em assinaturas ajudam a encontrar indícios de ataque já descritos, mas não avaliam o quanto a interação observada é característica de um dispositivo específico. O MLEP compara a atividade atual com o perfil de rede habitual do dispositivo: com quais nós ele interage, quais protocolos usa, quando e quantos dados transmite, qual é o tamanho médio do pacote etc. As mudanças identificadas ajudam a escolher a direção da investigação. A comparação com outros eventos e com o contexto operacional permite avaliar se pode haver ações maliciosas por trás delas. Na investigação de um incidente já detectado, as anomalias ajudam a reconstruir a sequência de ações.
A primeira versão do MLEP inclui seis monitores pré-configurados, um para cada tipo de desvio do perfil de rede habitual do dispositivo:
| Anomalia | Como ajuda na análise de eventos |
| Novo nó externo | Chama a atenção para uma nova conexão externa que não existia antes no comportamento observado do dispositivo, mesmo que o endereço IP não esteja entre os IoCs conhecidos. Ajuda a verificar se essa conexão surgiu no período de outros eventos suspeitos. |
| Nova combinação de endereço e porta de destino | Mostra que o dispositivo começou a usar um novo serviço pela primeira vez. Na investigação de um incidente já identificado, isso ajuda a rastrear novas conexões depois da análise dos eventos mais críticos. |
| Volume de dados enviados excepcionalmente grande | Destaca uma transmissão de dados atípica para o dispositivo e ajuda a comparar o horário e a direção dela com outros eventos. |
| Horário de atividade atípico | Mostra que o dispositivo funcionou em um horário incomum para ele. Na investigação de um incidente já identificado, isso ajuda a reconstruir a cronologia das ações em torno do alerta principal. |
| Novo protocolo | Ajuda a perceber o surgimento de uma nova forma de interação, mesmo quando o dispositivo interage com nós já conhecidos. |
| Atividade com indícios de varredura | Mostra que o dispositivo passou a se conectar a um número excepcionalmente grande de nós vizinhos. Esse sinal ajuda a identificar um possível reconhecimento antes de tentativas de acesso ao equipamento. |
Na investigação, as anomalias ajudam a reconstruir a sequência de mudanças: quando surgiram novas conexões em um nó específico, quando o protocolo mudou, quando o volume de transmissão de dados aumentou ou quando o horário de funcionamento se deslocou. Ao correlacionar os eventos por dispositivo e por horário, o analista vê como a atividade se desenvolveu em torno de um incidente já detectado.
Isso é particularmente útil quando parte das ações do invasor ficou fora da área de observação ou não acionou outras tecnologias do KICS. Ao correlacionar as mudanças com a função do dispositivo, os dados da análise de protocolos e os eventos de outras tecnologias, o especialista obtém uma cronologia mais completa. As anomalias comportamentais mostram exatamente onde procurar os elos ausentes e quais interações de rede exigem atenção.
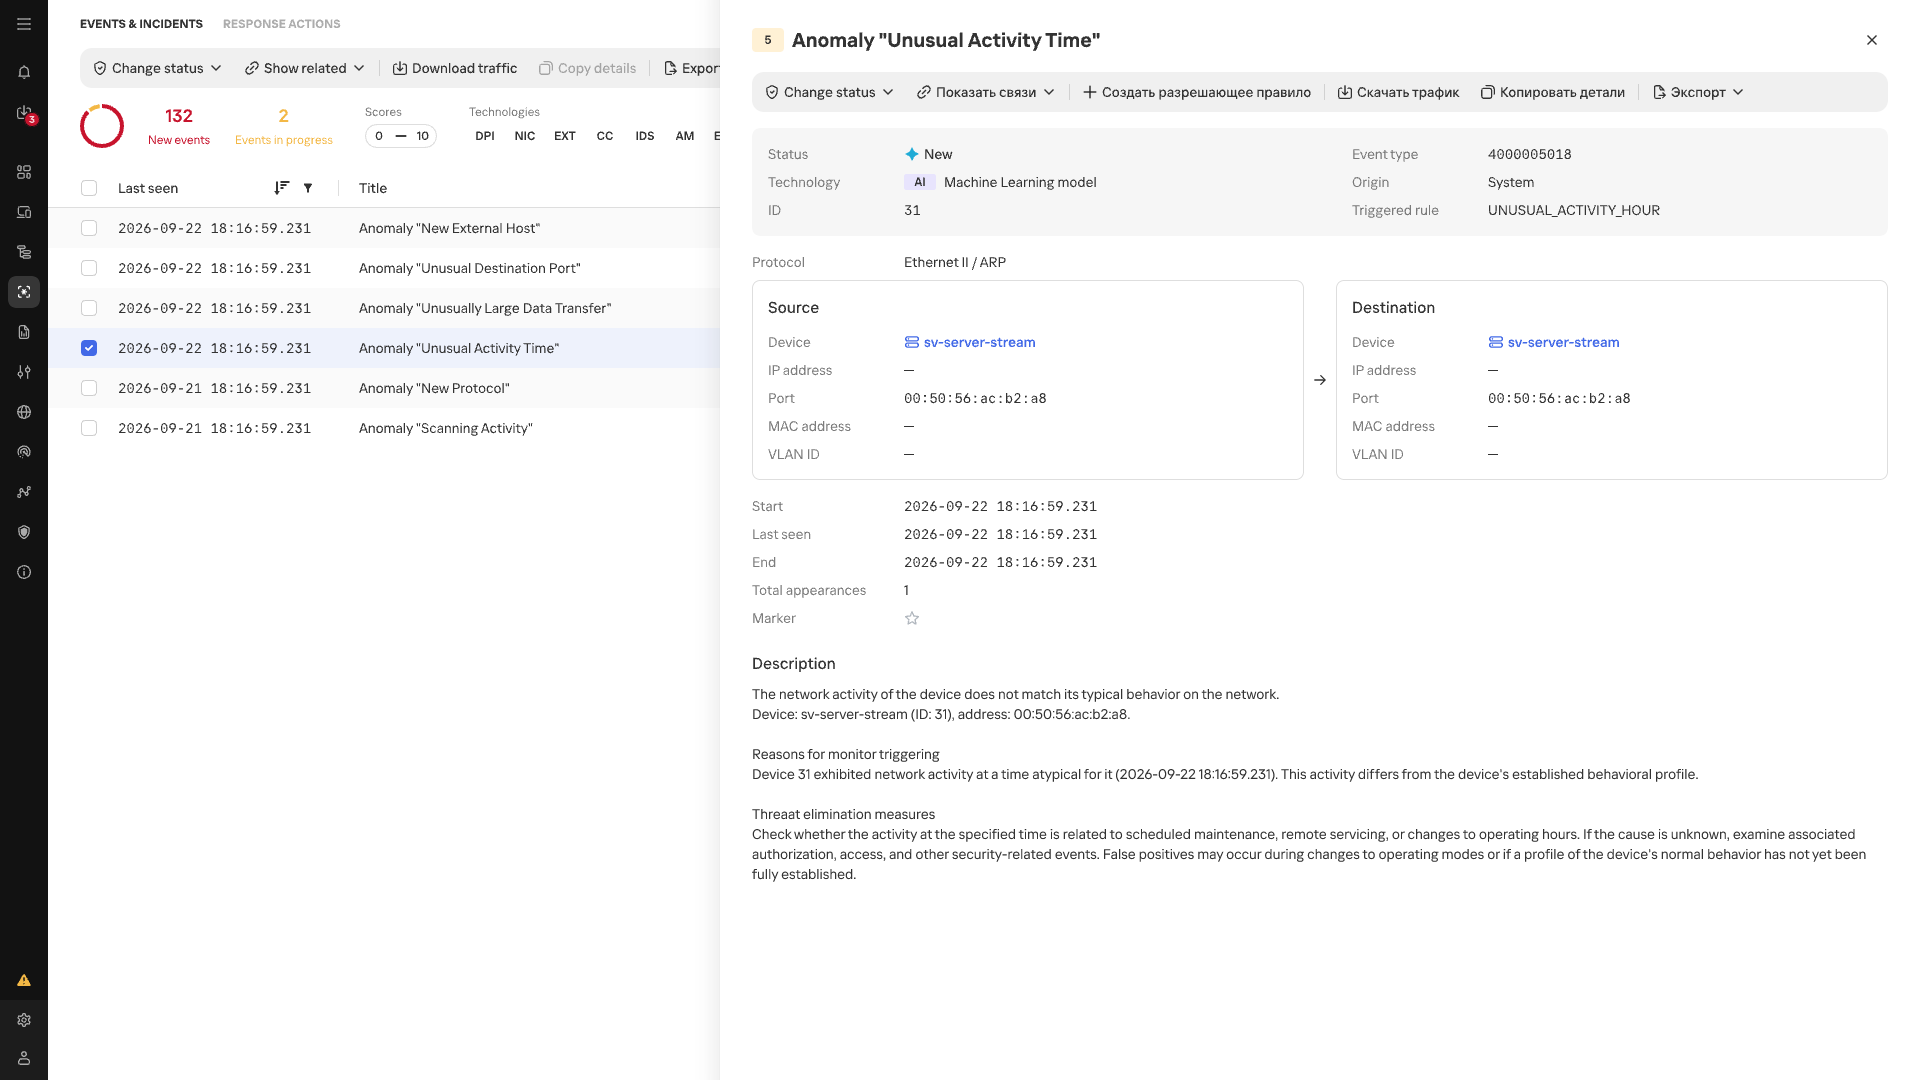
Cartão da anomalia “Horário de atividade atípico”
Na lista de eventos, as anomalias identificadas pelo MLEP aparecem com a marca IA. Para cada evento, são exibidos o nome, a origem, o destino, o timestamp e o identificador do cenário acionado.
Conclusão
Em uma rede industrial, o caráter anômalo de um comportamento depende do nó em que ele surgiu e do papel desse nó no processo industrial. A repetitividade de muitas comunicações ajuda a perceber mudanças na troca de dados habitual, e as informações sobre a função e a criticidade do dispositivo ajudam a entender as possíveis consequências. Quando essas observações são analisadas em conjunto, o tráfego de rede oferece mais do que uma lista de conexões: ele ajuda a avaliar novos eventos no contexto de uma instalação específica, mesmo sem um cenário de ataque conhecido de antemão. Esse tipo de análise abrangente é bem executado por tecnologias de machine learning, capazes de processar e sistematizar enormes fluxos de dados heterogêneos. No Kaspersky Industrial CyberSecurity for Networks, a partir da versão 5.0, essa função fica a cargo da tecnologia MLEP, que funciona com eficiência em conjunto com os recursos já existentes no produto.
Autores


MLEP no KICS for Networks 5.0: como o machine learning ajuda a monitorar o comportamento de rede de dispositivos OT