

O usuário confia ao provedor de nuvem a configuração e a manutenção dos serviços de TI, incluindo o armazenamento de dados. Por sua vez, o provedor garante que os serviços hospedados em sua infraestrutura não sairão do ar e que os dados serão armazenados em regime de estrita confidencialidade.
Para comprovar a segurança de suas plataformas, os provedores adotam estratégias diferentes. Alguns lançam programas de bug bounty, outros confiam em auditorias internas regulares e outros ainda contratam equipes de pesquisa externas. No entanto, a metodologia de testes de invasão em infraestruturas de nuvem ainda tem muitas lacunas, pois não existe um padrão único e o sucesso da avaliação depende da experiência e do nível de cada equipe.
A maior parte dos pentests nessa área se concentra tradicionalmente no perímetro externo, em que se testam o painel de gerenciamento, as interfaces do cliente, as APIs e o perímetro de rede básico. Essa camada é importante, mas ainda superficial.
Este artigo é introdutório. Nele, compartilhamos nossa abordagem para testes de invasão em ambientes de nuvem, construída ao longo de vários anos em dezenas de projetos. Não pretendemos cobrir de forma exaustiva todos os cenários possíveis, mas queremos mostrar a lógica de raciocínio durante os pentests e destacar pontos menos óbvios, que nem sempre chamam a atenção.
Pontos-chave
- A infraestrutura de nuvem é mais complexa do que uma aplicação web clássica. De forma simplificada, ela pode ser representada como um hotel com três zonas: o site de reservas (External, o perímetro externo), os quartos dos hóspedes (Overlay, a camada lógica) e a área dos funcionários (Underlay, a camada de infraestrutura/base). Um serviço de nuvem está bem protegido quando não é possível transpor as fronteiras de confiança entre esses perímetros.
- O valor de um pentest de nuvem não se mede pela quantidade de vulnerabilidades encontradas nem pelo simples fato de executar código. A execução remota de comandos em um container isolado do cliente é apenas o começo do pentest, e não o final. O objetivo principal é provar que um invasor consegue transpor as fronteiras de confiança.
- A pesquisa deve responder a cinco perguntas críticas: se o invasor consegue ler, alterar ou excluir dados de outros clientes; se é possível assumir o controle da conta de serviço IAM do provedor; se o comprometimento do ambiente de execução leva à propagação do ataque para outros recursos e serviços; se é viável afetar os recursos internos do provedor a partir de segmentos com baixo nível de confiança; e se é possível escapar do ambiente virtual.
- Um resultado negativo também é um resultado. Se o pentester não conseguiu passar do ambiente do cliente (tenant plane) para o ambiente interno do provedor (provider overlay), essa é uma conclusão valiosa. Ela mostra quais fronteiras de proteção funcionam na prática e quais se sustentam apenas em suposições e exigem mecanismos de controle adicionais.
Principais termos
A seguir, explicamos alguns termos específicos usados com mais frequência em infraestruturas de nuvem.
Mostrar definições
Tenant (do inglês tenant, inquilino ou locatário): unidade logicamente isolada dentro de uma plataforma de nuvem. Pode ser, por exemplo, um usuário (em particular, uma organização), um projeto ou uma conta específica na nuvem ou outra unidade de isolamento administrativo e de recursos.
Plano do cliente (tenant plane): serviços de TI e dados que o cliente gerencia normalmente, como máquinas virtuais, clusters Kubernetes, bancos de dados, armazenamentos de objetos e aplicações gerenciadas.
Painel de gerenciamento (management console): interface gráfica web e ponto de entrada do cliente na camada External.
Ambiente de execução do serviço (service runtime): ambiente real em que o produto de nuvem do provedor é executado, seja um processo, container, pod, máquina virtual ou microVM.
Plano de gerenciamento do serviço (service management plane): componentes internos do provedor que criam, atualizam, reiniciam, fazem backup e excluem o ambiente de execução do serviço (service runtime).
Conta de serviço IAM (service identity): identificador digital especial para programas, bots, serviços de nuvem ou servidores que permite que eles acessem de forma automática e segura os recursos de nuvem necessários, sem intervenção humana.
Contexto (em segurança de nuvem): conjunto de atributos e credenciais que define as permissões atuais e o ambiente de execução de um sujeito no sistema. Inclui o identificador utilizado (por exemplo, o token de uma conta de serviço, um certificado ou uma chave), o nível de privilégios (funções, políticas IAM) e o ambiente técnico (container, máquina virtual, segmento de rede) a partir do qual a solicitação é iniciada.
Zona inicial (initial zone): contexto em que o pesquisador se encontra logo após a primeira transição bem-sucedida, ou seja, o ambiente de execução específico (runtime), a conta de serviço IAM (service identity), o namespace, as rotas de rede e o conjunto de serviços disponíveis.
Ambiente interno do provedor (provider overlay): ambiente oculto do cliente e acessível a partir da zona inicial (initial zone), que abrange segmentos de rede, zonas DNS, APIs de serviço e componentes de gerenciamento.
Plano de controle (control plane): componentes da plataforma que tomam decisões globais de gerenciamento e alteram seu estado, ou seja, alocam recursos, atribuem permissões, configuram a rede e coordenam o estado.
Plano de dados (data plane): componentes que transportam ou processam dados de usuários e tráfego de aplicações. Existem componentes (ou sistemas) que ficam na interseção de diferentes níveis arquiteturais e, por isso, não podem ser atribuídos automaticamente ao plano de dados ou ao plano de controle.
Exemplos disso são os sistemas de registro de logs (logging), de backup e de faturamento. Eles mudam de papel conforme a tarefa que executam no momento e a forma como seu funcionamento afeta o tráfego de usuários.
Célula (cell): fragmento delimitado da plataforma dentro do qual componentes de computação, disco, rede ou gerenciamento são compartilhados (muitas vezes vinculado a uma região, zona de disponibilidade, tipo de serviço ou grupo de clientes).
Pods (do inglês pod, vagem): as menores unidades de computação no Kubernetes. Consistem em um ou mais containers implantados no mesmo host e que compartilham recursos.
Impacto entre tenants (cross-tenant impact): impacto confirmado a partir do contexto de um tenant sobre os recursos de outro, sem uma relação de confiança prevista pela arquitetura.
Impacto no nível do provedor (provider-level impact): efeito sobre um componente de gerenciamento, de infraestrutura ou da cadeia de suprimentos do provedor que vai além do recurso original do cliente.
Carga de trabalho do cliente (tenant workload): conjunto de recursos computacionais, processos e aplicações que o cliente executa e usa em seu tenant para realizar tarefas de negócio. Inclui máquinas virtuais, containers (por exemplo, um pod no Kubernetes), funções serverless, bancos de dados gerenciados e quaisquer outros serviços ativos que processem dados do cliente.
O que o pentester precisa verificar
No âmbito do projeto, o pentester precisa estudar não só o painel de gerenciamento, mas também as fronteiras entre o ambiente do cliente, os serviços gerenciados e a infraestrutura interna do provedor. Uma única solicitação passa por diversos componentes, do gateway de API ao sistema de armazenamento.
Um erro de configuração em qualquer um deles muda o contexto do ataque, dando ao pesquisador uma conta de serviço IAM, acesso à rede interna da nuvem ou a possibilidade de afetar o tenant de outro cliente.
Por isso, o pentest de nuvem não é apenas uma busca de vulnerabilidades no painel de gerenciamento nem uma varredura sequencial das sub-redes da nuvem. Acima de tudo, é a verificação das fronteiras de confiança, ou seja, o controle das transições entre zonas com diferentes níveis de confiança. A zona mais confiável considera potencialmente hostil tudo o que chega da zona menos confiável.
O que torna uma fronteira real? Os mecanismos de controle: autenticação e autorização (IAM, RBAC), isolamento (virtualização, conteinerização, segmentação de rede), criptografia (mTLS), tratamento de dados de entrada, entre outros. Construímos um mapa das fronteiras potenciais e verificamos cada uma delas para saber se é de fato garantida por mecanismos de controle ou se depende de suposições (arquiteturais, de infraestrutura, de implementação etc.).
A plataforma de nuvem como objeto de pesquisa
Ao iniciar a análise de segurança de um sistema tradicional, normalmente partimos de padrões arquiteturais básicos. Para aplicações web, trata-se de uma stack convencional composta por servidor web (Nginx, Apache etc.), lógica do lado do servidor, armazenamento de objetos e integrações com serviços de terceiros. Para soluções de hardware, trata-se da cadeia que vai das interfaces físicas ao firmware e aos handlers de protocolos.
As soluções de nuvem se caracterizam por uma grande incerteza na implementação arquitetural. Os padrões e as arquiteturas de referência de computação em nuvem (por exemplo, NIST SP 800-145 e ISO/IEC 17788) definem os papéis dos participantes e as relações entre os componentes da nuvem, mas não impõem regras rígidas para a implementação da plataforma.
Por não haver um regulamento técnico único, um banco de dados gerenciado (managed database) aparentemente idêntico funciona de maneiras diferentes conforme o provedor. Em um, ele roda dentro de uma máquina virtual isolada; em outro, dentro de um namespace de um cluster Kubernetes compartilhado; e, em um terceiro, dentro de um cluster dedicado do ambiente do cliente (tenant cluster). A mesma variabilidade se aplica à escolha de software. O provedor pode usar OpenStack, Kubernetes, um plano de controle próprio ou uma combinação deles. Por isso, um nome de produto conhecido não dá uma visão completa da estrutura interna do sistema.
Por esse motivo, o pentest de nuvem é mais complexo do que a análise de um sistema tradicional. Depois de transpor a fronteira de confiança do cliente (por exemplo, escapando de uma microVM para o sistema operacional do host), a pesquisa deixa de ser uma simples busca pela próxima porta aberta e passa a ser a reconstrução da arquitetura a partir de indícios indiretos. O pentester monta o quebra-cabeça estudando processos em execução, rotas de rede, certificados, nomes de serviços e a configuração de agentes. É a partir deles que o pesquisador determina o papel de cada componente e suas fronteiras de confiança.
Para não vincular nossa abordagem a um fornecedor específico, analisaremos a infraestrutura de nuvem independentemente de marcas concretas. Dependendo do cenário arquitetural, um mesmo componente pode ser implementado de maneiras fundamentalmente diferentes. Por exemplo, um banco de dados gerenciado pode, no primeiro caso, funcionar como um serviço gerenciado separado, isolado no nível da máquina virtual (onde os principais riscos são a segurança do hipervisor e da API de gerenciamento) e, no segundo caso, como um container dentro de um cluster Kubernetes compartilhado (onde a ameaça está ligada ao escape do container para o host e à qualidade do isolamento do namespace).
A analogia do hotel e os três níveis da nuvem
Para sistematizar o pentest na ausência de um padrão único de construção de infraestrutura de nuvem, usamos uma divisão interna da nuvem em três camadas: External, Overlay e Underlay. A forma mais simples é imaginar a plataforma de nuvem como um grande hotel, que tem uma área pública para os hóspedes, áreas de serviço para os funcionários e andares técnicos com instalações de engenharia. Essa analogia não cobre todos os detalhes, mas mostra bem como se distribuem as zonas de responsabilidade e as transições entre elas.
Camada externa (External): no hotel, é o site de reservas, e também as portas e a recepção. Nessa camada, o pentester interage com os componentes da nuvem da mesma forma que um usuário comum: faz login na conta, acessa a API pública, cria serviços de TI e se conecta aos endpoints deles. O trabalho nessa camada é semelhante a um teste de invasão externo ou a uma avaliação de segurança de aplicações. O objetivo principal é obter acesso inicial, a partir do exterior, ao tenant de outro cliente ou passar para a camada Overlay.
Na camada External, o acesso ao tenant é concedido normalmente. No hotel, é o próprio quarto. O hóspede dispõe dos objetos e equipamentos dentro do seu quarto, mas seu cartão não deve abrir os quartos vizinhos. Na nuvem, o cliente gerencia apenas os próprios dados, máquinas virtuais, pods, bancos de dados, armazenamentos de objetos (S3 buckets) e contas dentro do seu projeto. O tenant não é uma camada separada da infraestrutura, mas aquilo que o usuário recebe na camada External. É justamente aqui que terminam suas permissões legítimas e começa a primeira fronteira de confiança verificada pelo pentester.
Camada de serviços do provedor (Overlay): no hotel, é a área “restrita a funcionários”, com cozinhas, lavanderias, sala de controle, corredores de serviço e o sistema de chaves mestras. Na infraestrutura de nuvem, é a camada lógica interna de gerenciamento de serviços: ambientes de execução de serviços gerenciados, agendadores, sistemas de backup, monitoramento (observability) e faturamento, o sistema IAM e as APIs internas. O cliente usa o resultado do trabalho deles, mas não deve obter acesso a eles de forma não prevista pela arquitetura.
É importante não confundir esse termo com a rede overlay da engenharia de redes clássica (uma rede lógica sobre a rede de transporte underlay, por exemplo, segmentos VXLAN). Em nossa metodologia, Overlay tem um sentido mais amplo e designa a camada lógica interna de execução e gerenciamento de serviços de nuvem, que pode ser subdividida conforme a nuvem específica. Na tabela abaixo, para maior clareza, ela está dividida em duas subcamadas: os ambientes de execução dos serviços do cliente e os componentes internos do provedor.
Camada de infraestrutura (Underlay): no hotel, são as instalações de engenharia, os equipamentos elétricos e os sistemas de controle de acesso físico, que garantem o funcionamento do prédio como um todo. Na nuvem, é a camada de hardware: servidores físicos, sistemas operacionais de host, hipervisores, rede de transporte, sistemas de armazenamento e gerenciamento fora de banda. Um trabalho descuidado nessa camada pode causar consequências destrutivas graves.
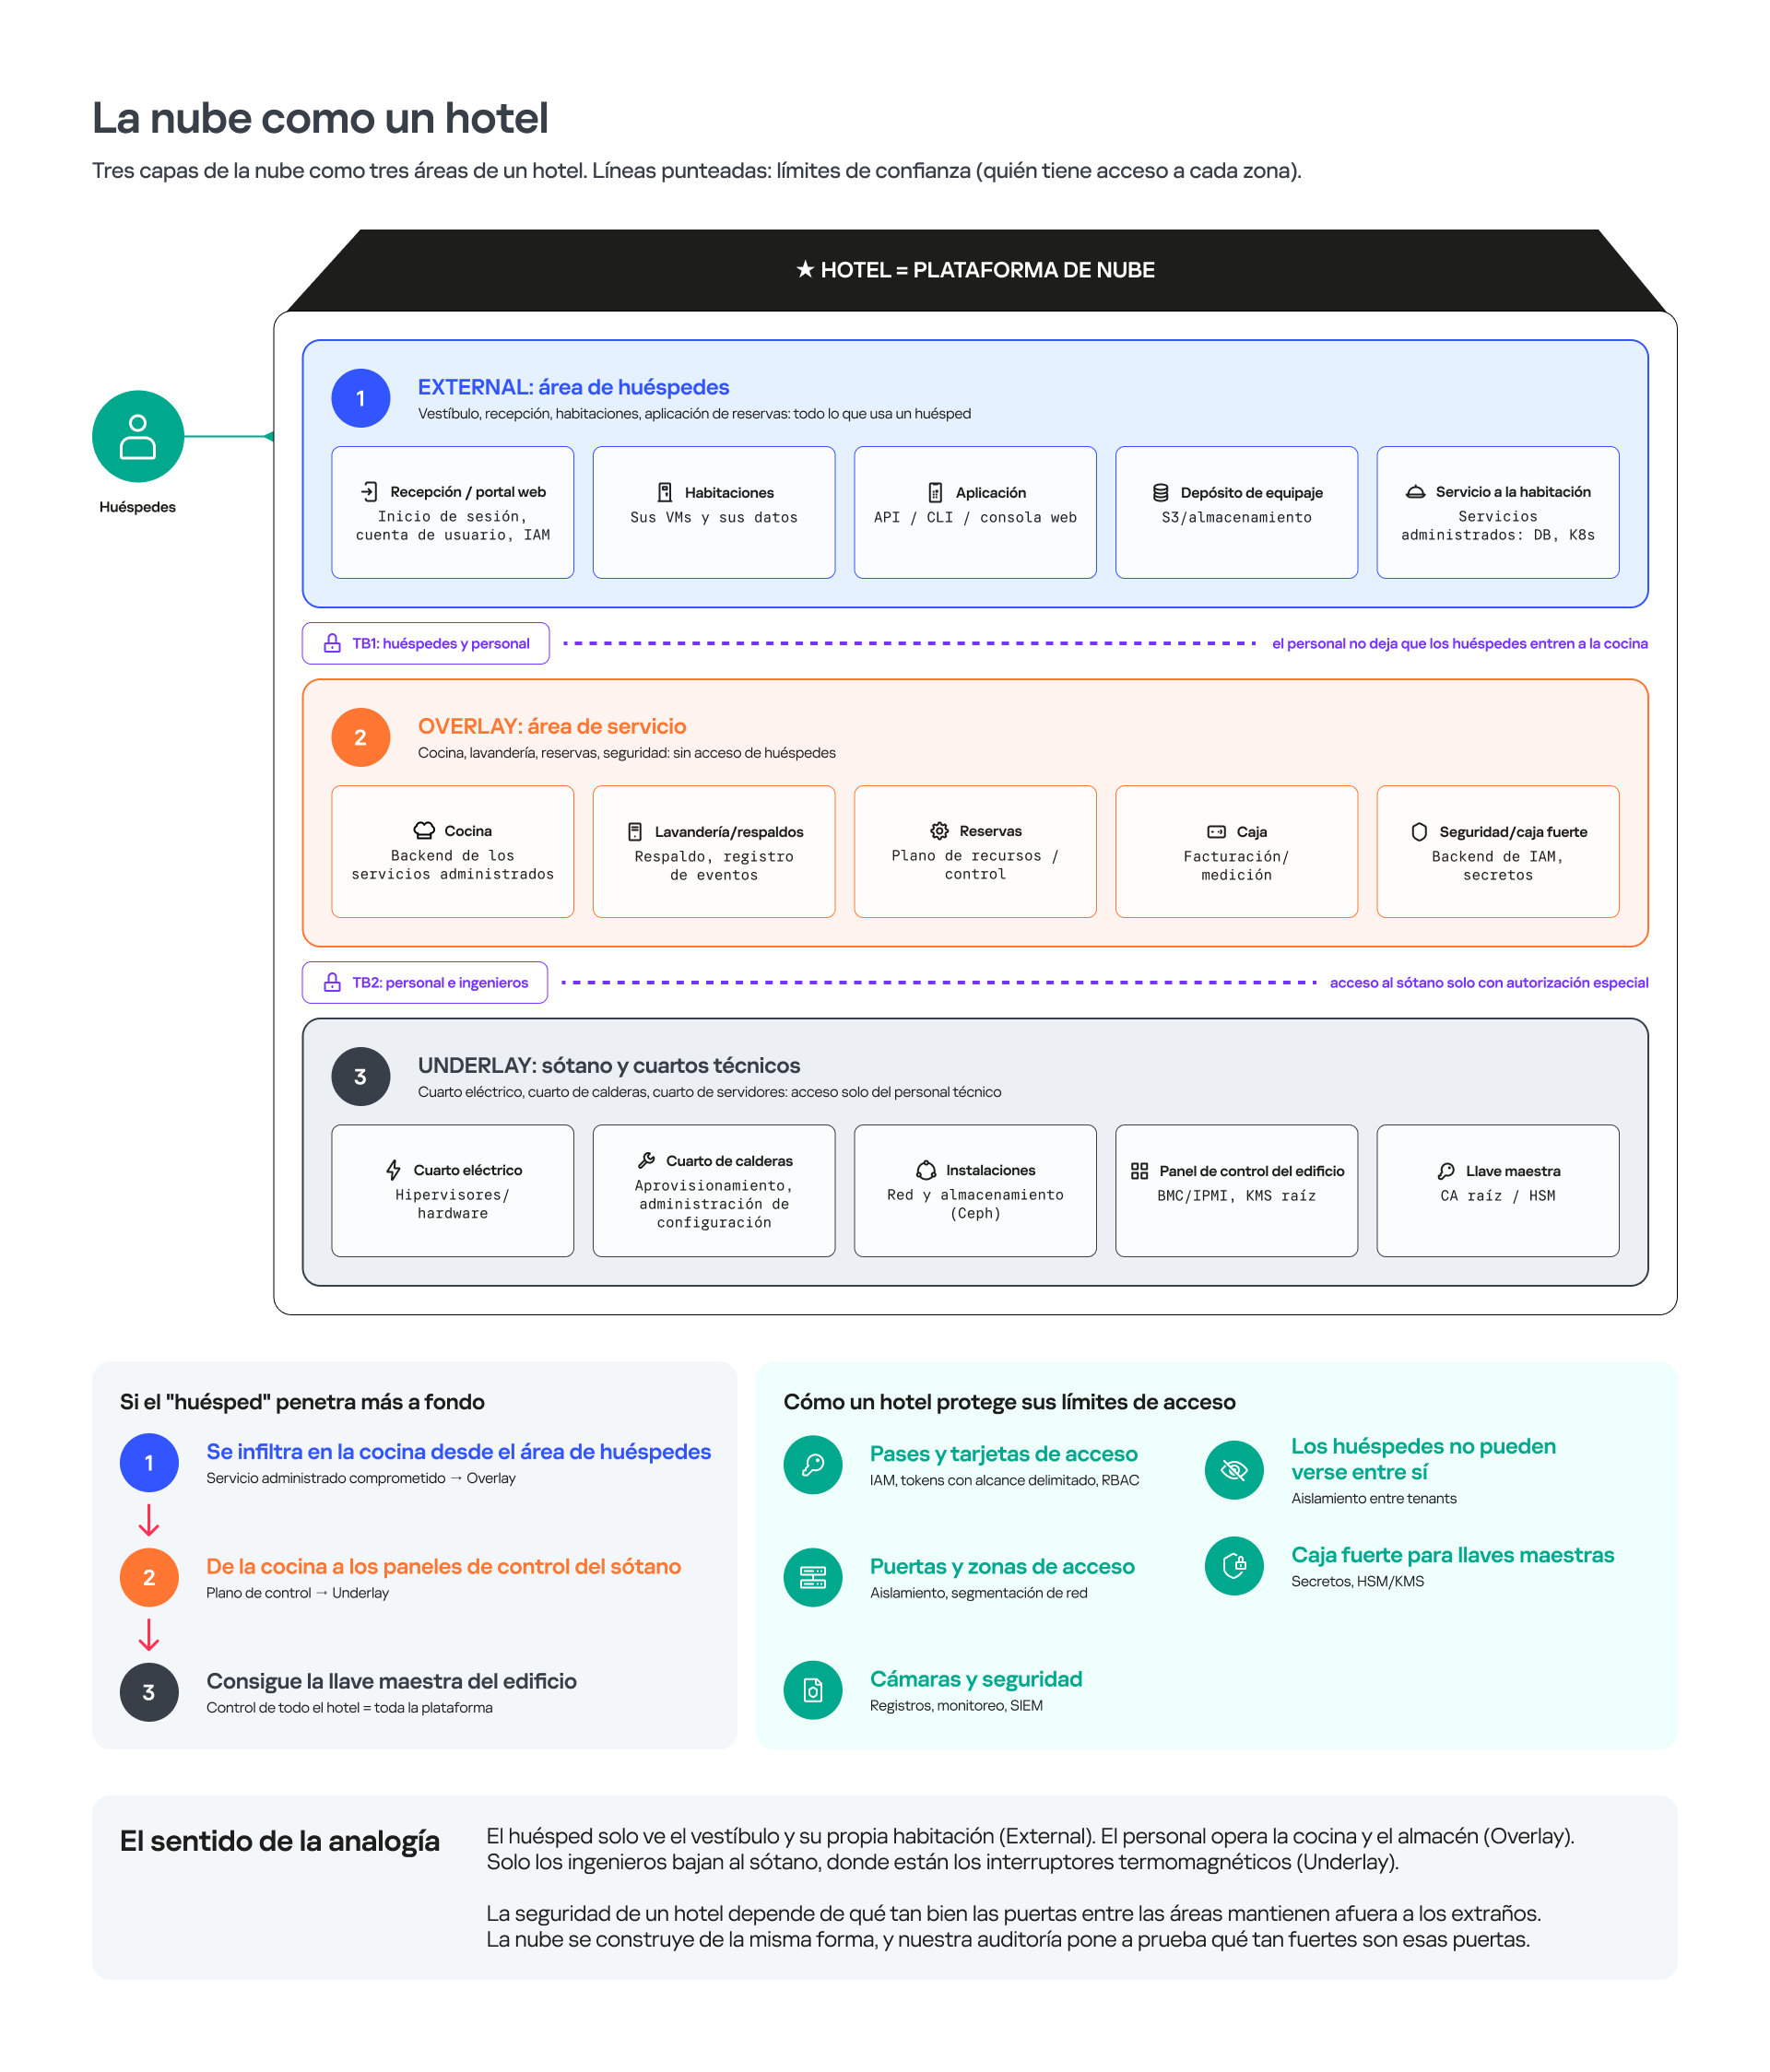
Mas o principal nessa analogia não são os cômodos em si, e sim as portas entre eles. Uma vulnerabilidade no site de reservas é perigosa, mas uma chave mestra encontrada em um quarto, capaz de abrir todas as portas do edifício ou de um grupo de cômodos, é muito mais perigosa. Na nuvem vale a mesma regra. A possibilidade de execução remota de código (RCE) dentro de um container isolado do cliente (pod) é apenas um problema local. O comprometimento de uma conta de serviço IAM que gerencia os recursos de uma região afeta toda a plataforma.
Abaixo há uma tabela com exemplos de componentes, pontos de entrada do pentester e objetivos de verificação para cada camada. Dividimos a camada Overlay em duas subcamadas, pois o ambiente de execução do serviço do cliente e a infraestrutura interna do provedor têm fronteiras de confiança e pontos de entrada diferentes.
| Camada | O que há dentro | Ponto de entrada típico do pentester | Objetivo principal da verificação |
| External (camada externa) | Interface pública da nuvem (API), painel de gerenciamento, IAM, endpoints de interação com serviços de TI, SDK. | A internet ou uma conta comum de cliente. | Obtenção de acesso inicial ao ambiente do cliente (tenant), execução de código, comprometimento da conta de serviço IAM (service identity). |
| Overlay (serviços de TI) | Ambiente de execução do serviço (runtime): sistema operacional e seus componentes, agentes de serviço do provedor e do produto, SGBD. | Consultas SQL do usuário, código executado dentro de tarefas, plugins importados ou imagens de sistemas operacionais. | Burlar o isolamento do ambiente de execução do serviço (runtime) e detectar privilégios excessivos da conta de serviço IAM atribuída (service identity). |
| Overlay (componentes do provedor) | Sistema de faturamento, backups, monitoramento, sistema de controle de acesso, API interna da nuvem. | Zona inicial (initial zone) confirmada, obtida no passo anterior ou fornecida pelo provedor de nuvem para reduzir o tempo. | Transpor as fronteiras entre serviços, burlar o isolamento de tenants, encontrar formas de interagir com o plano de controle ou com os serviços de TI. |
| Underlay (camada de infraestrutura) | Sistemas operacionais de host, sistemas de virtualização (hipervisores), rede de transporte, sistemas de armazenamento de dados, controladores de gerenciamento de hardware (BMC) e outros mecanismos de baixo nível. | Máquina virtual controlada com acesso à camada de infraestrutura ou conta de serviço IAM privilegiada (service identity). | Verificar o isolamento da virtualização e das cargas de trabalho vizinhas, bem como a escala real do impacto. |
Uma plataforma de nuvem real nem sempre se encaixa nessa matriz. O ambiente de execução do serviço pode ser uma máquina virtual específica, um pod em um cluster compartilhado ou uma microVM. O hipervisor pertence à camada Underlay, mas sua API de gerenciamento pode estar acessível a partir da camada Overlay. Por isso, a camada atual (External, Overlay ou Underlay) em que o pentester se encontra é determinada não só pelo endereço IP, mas pela combinação de quatro características:
- Quem controla o componente da infraestrutura de nuvem.
- De quem são os dados e recursos que ele gerencia.
- Qual conta de serviço IAM é usada para a interação.
- Qual é o alcance de suas permissões.
Por onde passam as fronteiras de confiança
Ao analisar a rede que sustenta a infraestrutura interna da nuvem, é fácil concluir erroneamente que existe apenas uma fronteira de confiança, entre o cliente e o provedor. Mas o acesso do pentester à rede interna do provedor pode ser apenas o primeiro passo. Dentro de uma plataforma real existem muitas zonas com diferentes níveis de confiança, e o comprometimento de um componente não dá necessariamente acesso a toda a infraestrutura. Por exemplo, a solicitação de um usuário pode passar sucessivamente pela interface do cliente (painel de gerenciamento), depois pelo ambiente do cliente (banco de dados), em seguida pelo ambiente de execução do serviço (a máquina virtual na qual o banco de dados é executado), depois pelo plano de gerenciamento do serviço (serviço interno de monitoramento do estado do banco de dados) e pelo plano de controle da nuvem (serviço interno de gerenciamento dos recursos do banco de dados) e só então, finalmente, chegar à camada de infraestrutura.
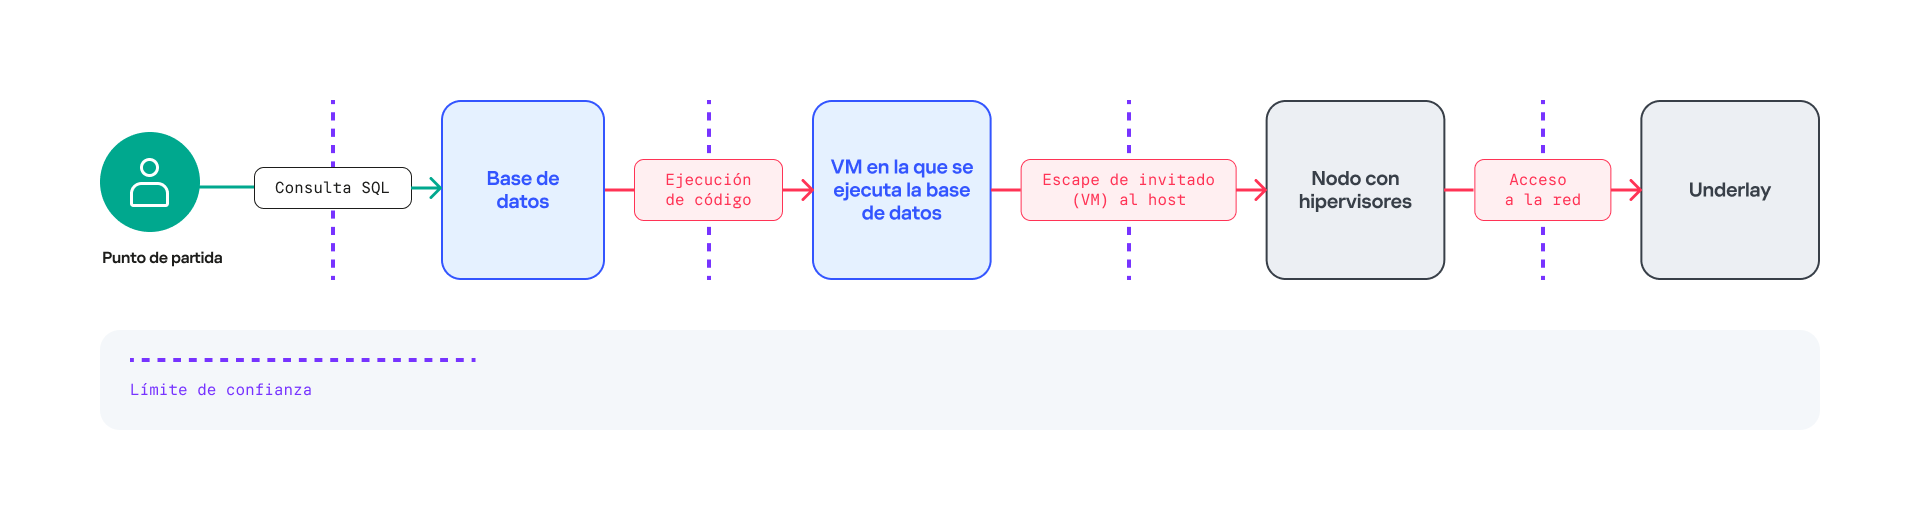
Cada transição muda a zona de confiança, mas não significa necessariamente a entrada em uma nova sub-rede ou a obtenção de privilégios root. É como passar por catracas dentro de um mesmo prédio. Não saímos para a rua (ou seja, para uma nova sub-rede) nem recebemos as chaves de todas as portas (privilégios root), mas em cada novo posto de controle nosso crachá é verificado novamente, porque depois dessa catraca valem outras regras de segurança. Às vezes a fronteira passa entre duas funções em um mesmo processo, às vezes entre a API e um worker e, às vezes, entre a máquina virtual convidada e o hipervisor. Quanto à fronteira entre a API e o worker, uma vulnerabilidade pode surgir de diferenças no processamento de dados. A API interna da nuvem recebe do usuário uma string com um byte nulo (\x00), considera-a válida e a repassa, enquanto o worker em segundo plano confia cegamente nesses dados e os insere em uma consulta de baixo nível ao SGBD PostgreSQL. Como, para as bibliotecas em linguagem C, o caractere \x00 indica o fim definitivo da string, o handler do banco de dados trunca o texto no ponto em que esse byte foi injetado, o que quebra a lógica da consulta SQL ou da verificação de permissões, descarta o contexto do usuário comum e faz o sistema alterar a senha do administrador principal (postgres), levando ao controle total do banco de dados.
Exemplo 1. Isolamento rigoroso (SGBD gerenciado)
O cliente aluga um banco de dados gerenciado em seu tenant. Ele pode executar consultas SQL, mas não pode se conectar ao sistema operacional em que o banco é executado. Aqui, a fronteira de confiança passa entre as permissões da função no SGBD e o ambiente de execução do seu processo. Se, por meio de consultas SQL permitidas, o pentester conseguir passar à execução de código no nível do sistema operacional em nome do processo de serviço, o pesquisador obtém acesso completo aos recursos do host. Isso permite não apenas coletar informações, mas interagir ativamente com o host: ler e modificar arquivos, analisar processos em execução, estabelecer conexões de rede com serviços internos e extrair credenciais (por exemplo, o token da conta de serviço IAM) para atacar outros componentes da nuvem.
Exemplo 2. Acesso legítimo (máquina virtual gerenciada)
Em outra implementação, o provedor oferece autenticação por chave SSH nativamente, e o usuário se conecta ao recurso como a uma máquina virtual comum. Formalmente, o produto continua se chamando “SGBD gerenciado”, mas a fronteira de confiança real se desloca para um nível mais profundo, o da interação entre o sistema operacional convidado e a infraestrutura do host. O próprio acesso ao sistema operacional por SSH, nesse caso, não é uma violação, pois está previsto no modelo do serviço. É preciso verificar a próxima fronteira, entre a máquina virtual de serviço e os agentes de gerenciamento, os metadados, o host ou o plano de controle.
Disso decorrem algumas regras práticas:
- A execução normal de código do usuário, por si só, não prova um comprometimento do isolamento. Em serviços de TI como notebooks interativos (notebook), executores de tarefas de integração contínua (CI runner) ou sistemas serverless, a execução de código é uma função do produto.
- Obter privilégios máximos dentro de um pod não equivale a obter privilégios máximos no nó. Após cada transposição de uma fronteira de confiança (por exemplo, para uma zona com outros privilégios e contas de serviço), é preciso determinar novamente os processos visíveis, pontos de montagem, interfaces, dispositivos e contas de serviço IAM.
- Um token de conta de serviço IAM encontrado não é necessariamente útil para o pesquisador. O importante é quem o emitiu e quais sistemas o aceitam. Também importam o tenant ou o serviço a que ele está vinculado e as ações permitidas neles.
- O simples fato de ser possível acessar um endereço IP interno do provedor a partir de um container do cliente ainda não significa comprometimento. Em muitas nuvens, parte dos serviços internos fica normalmente acessível pela rede. Para o comprometimento, o invasor precisa interceptar um token de serviço ou encontrar um serviço interno que aceite por engano contas de clientes ou não exija autenticação.
- A execução remota de código dentro do ambiente em que o serviço é executado ainda não significa acesso ao plano de controle. É apenas a zona inicial, a partir da qual o pesquisador deve procurar a próxima fronteira de confiança: tokens de serviço, APIs internas do provedor, containers vizinhos.
Para distinguir a transposição real de uma fronteira de confiança de um falso positivo, usamos quatro estágios sucessivos do ponto de vista do pesquisador:
- Visibilidade de rede. O pesquisador enxerga um serviço interno do provedor a partir do ambiente do cliente. Isso ainda não é uma invasão, mas é o primeiro sinal de que o isolamento pode ser insuficiente.
- Autenticação. O pesquisador consegue “se apresentar” a um serviço que aceita um token ou certificado comprometido no passo anterior (por exemplo, o token de uma conta de serviço ou de metadados). Isso já é grave, pois o serviço considera a solicitação legítima.
- Autorização. O alvo do ataque concede permissões específicas ao contexto atual. Isso ainda não é a execução de operações perigosas, mas a verificação de que elas são permitidas.
- Ação controlada além da fronteira de confiança original. O pesquisador executa uma ação mínima e segura que confirma que as permissões obtidas funcionam na prática. Por exemplo, cria um registro de teste em um tenant vizinho (normalmente, um segundo tenant de teste).
Os dois primeiros estágios apenas levantam uma hipótese de transposição da fronteira de confiança. O alvo está visível na rede e aceita solicitações, mas isso ainda não significa que o pesquisador possa alterar algo nele. O impacto confirmado só aparece nos dois últimos estágios, quando é possível se autorizar e executar uma ação controlada além da fronteira original. Por exemplo, a acessibilidade de rede de um SGBD vizinho indica isolamento de rede insuficiente, mas o impacto entre tenants só surge quando, a partir do contexto original, é possível executar sobre um recurso de outro tenant uma ação não permitida pelo modelo da nuvem, como a leitura de dados. Por razões de hacking ético, o pesquisador demonstra essa leitura exclusivamente entre suas próprias contas de teste, para não violar a confidencialidade de usuários reais.
Modelo de invasor e três objetivos da pesquisa
A divisão da infraestrutura de nuvem em três camadas (External, Overlay, Underlay) ajuda a definir o modelo de invasor para cada uma delas. Durante o teste de invasão, o pesquisador pode se concentrar em uma camada e buscar todas as formas possíveis de transpor a fronteira de confiança mais próxima. Outra abordagem é construir uma cadeia de ataque completa através de todas as camadas. O modelo de invasor também define o ponto de partida, ou seja, com qual nível de acesso e de qual posição o pentest começa. A seguir, apresentamos uma lista universal de modelos de invasor aplicáveis à maioria das infraestruturas de nuvem:
- Invasor externo sem conta. Verificam-se a superfície pública, o cadastro, o mecanismo de login, os serviços acessíveis externamente e o caminho até o primeiro contexto de cliente. Camada
- Invasor com acesso legítimo ao tenant. Modelo-chave para uma nuvem multitenant. O cliente tem o direito de criar recursos próprios e tenta ultrapassar os limites deles. Camada
- Invasor interno com ambiente de execução (runtime) comprometido. O ponto de partida é um processo, pod ou máquina virtual infectados. O cenário é particularmente relevante para ataques à cadeia de suprimentos. O pesquisador estuda as possibilidades de movimentação lateral no ambiente de rede e de host. Camada Overlay ou Underlay.
- Invasor interno com token de conta de serviço IAM ou conta de operador comprometidos. Esse modelo prevê a verificação do IAM e dos processos de gerenciamento da plataforma de nuvem. Camada Overlay ou Underlay.
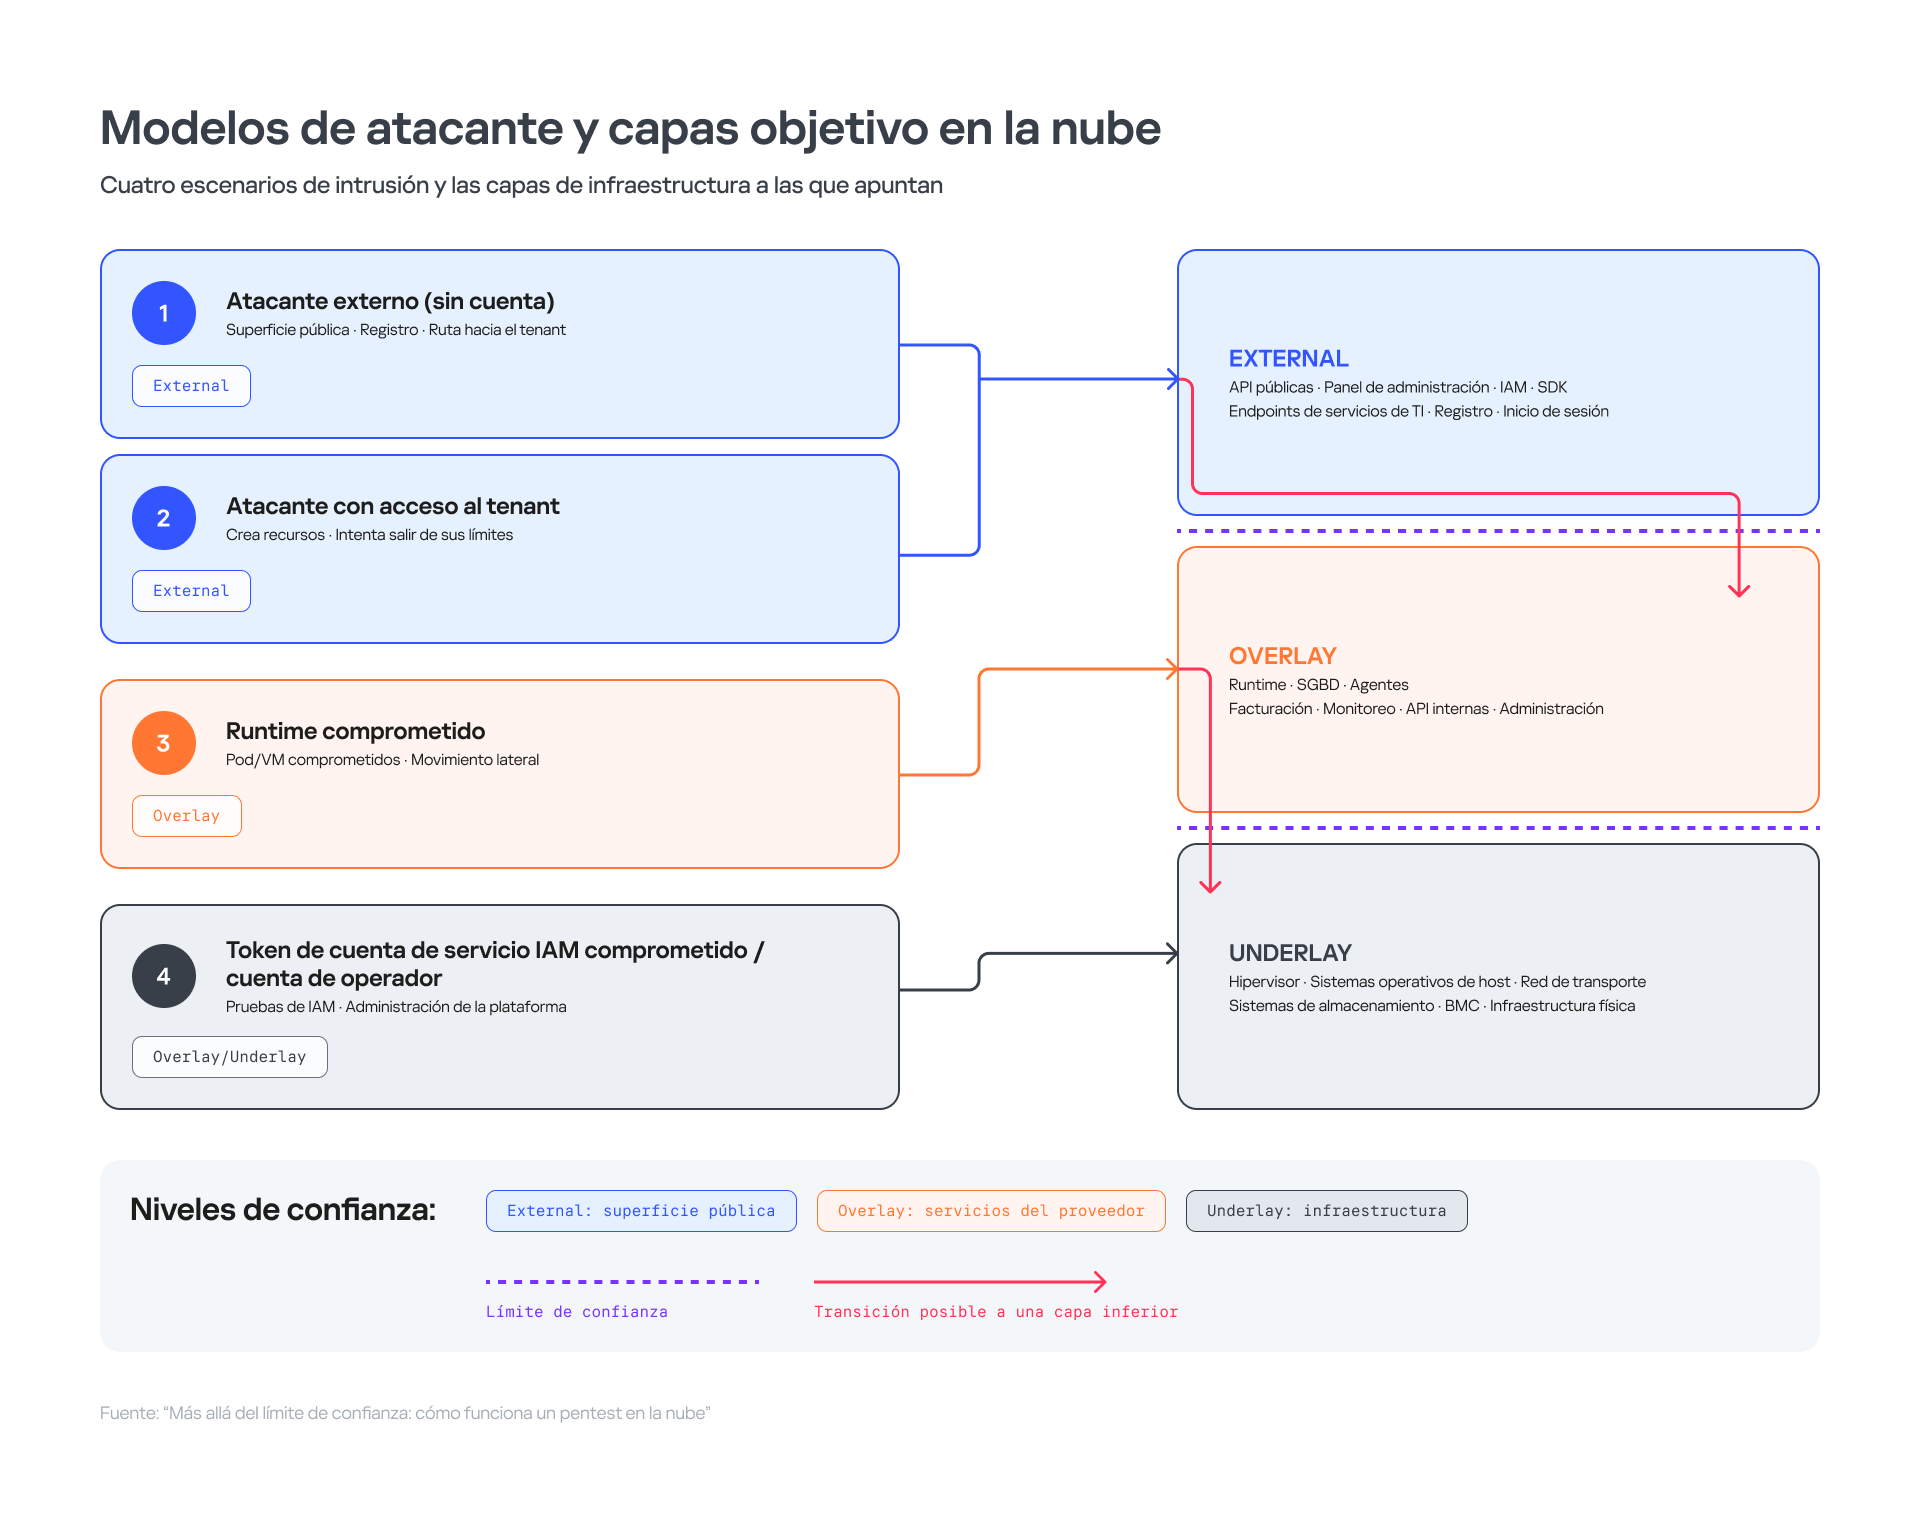
Independentemente do modelo de invasor e do ponto de entrada inicial, os objetivos da pesquisa no estágio inicial podem ser divididos em três grupos.
1. A execução de código
O objetivo dessa abordagem é executar código arbitrário dentro de um ambiente gerenciado pelo provedor. Para isso, o pentester pode atacar, por exemplo, um banco de dados gerenciado, uma função serverless, uma carga de trabalho de CI/CD, uma aplicação PaaS, uma máquina virtual do cliente, um container ou um gateway de rede virtual.
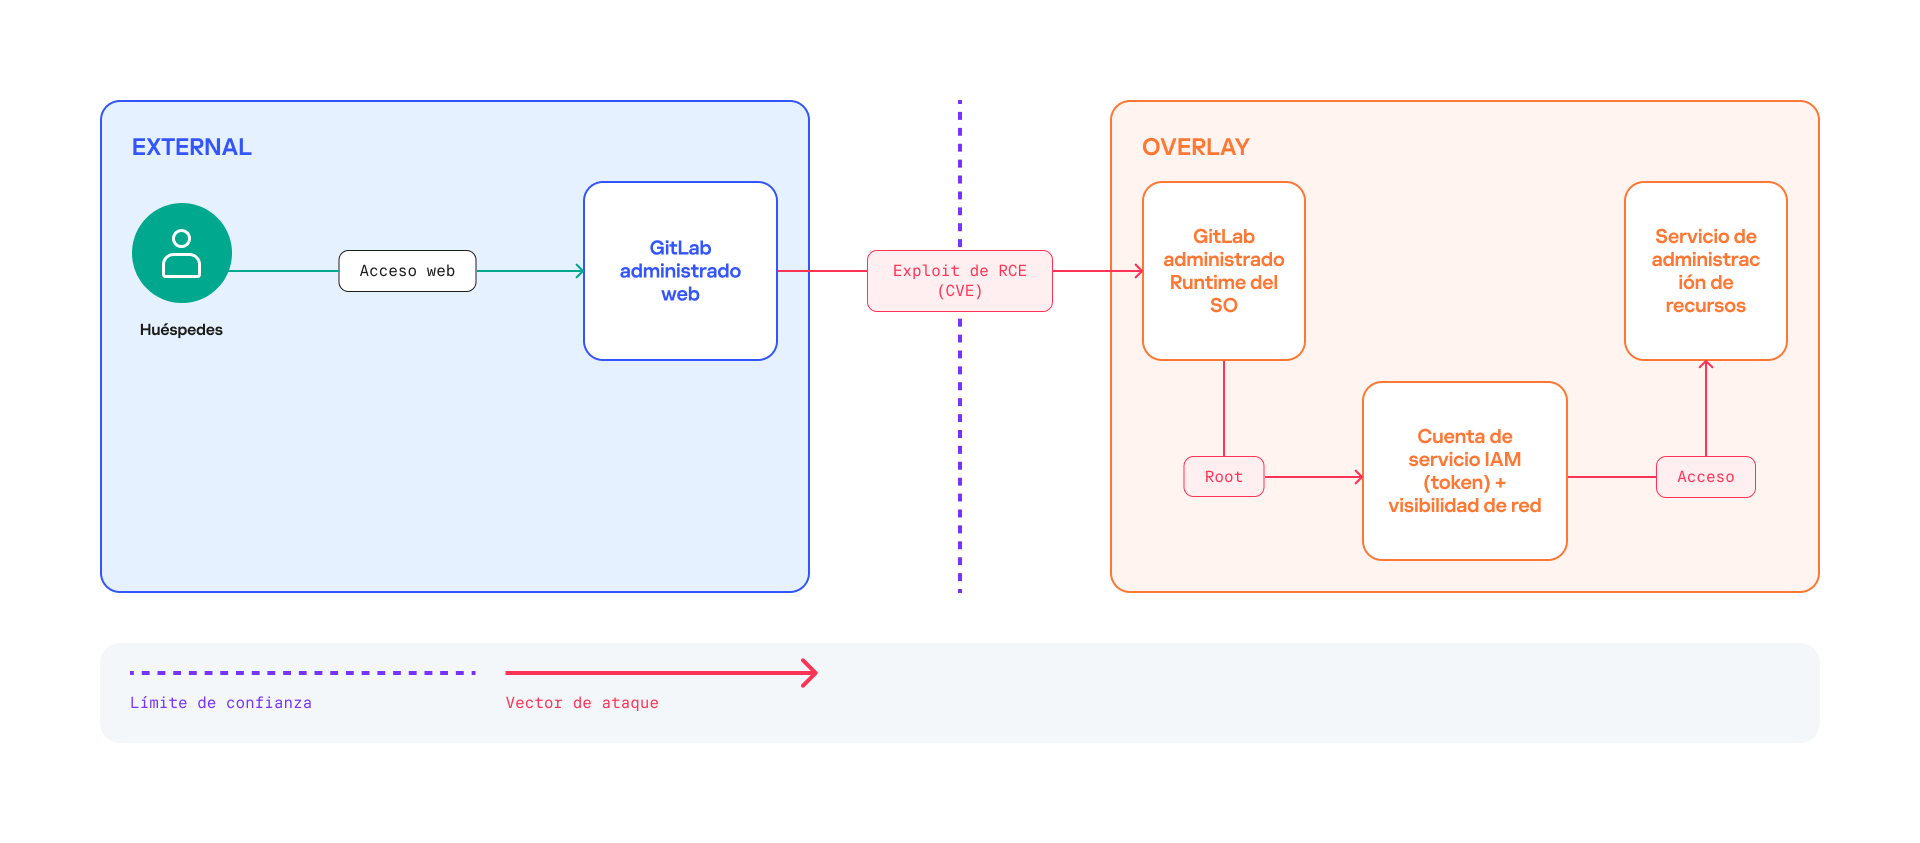
Exemplo de cadeia de ataque por meio de um serviço gerenciado
O pentester interage com a interface do serviço gerenciado e identifica uma vulnerabilidade nela (por exemplo, CVE-2026-19478, como no caso da interface web do GitLab) ou nos módulos adicionais implementados pelo provedor de nuvem. A vulnerabilidade permite ao pesquisador executar código remotamente dentro do ambiente de execução (no sistema operacional), encontrar uma conta de serviço IAM e, por meio dela, obter acesso ao serviço de gerenciamento de recursos. Em seguida, o pesquisador pode procurar vulnerabilidades nesse serviço e penetrar no ambiente interno do provedor (ou seja, na camada provider overlay).
Exemplo de cadeia de ataque por meio do ambiente virtual
A cadeia começa com o comprometimento de uma carga de trabalho do cliente (tenant workload). O pesquisador esconde previamente o código malicioso em uma imagem popular de sistema operacional ou de container. O cliente da nuvem baixa essa imagem infectada e a executa, e o invasor obtém acesso ao interior desse container específico. Em seguida, ele encontra formas de escapar do container (com a CVE-2026-43284) para o ambiente de execução, seja o runtime de containers, o hipervisor ou o agente do host. De lá, ele chega ao host compartilhado com outros containers e passa a poder afetar os componentes de gerenciamento do provedor.
2. As credenciais
Em vez de acesso ao ambiente de execução, o pesquisador pode obter credenciais reconhecidas pelos serviços de nuvem: o token de uma conta de serviço, credenciais de acesso aos metadados, um certificado mTLS, um token inicial (bootstrap) ou uma chave de armazenamento de objetos.
Nesse cenário, a passagem para o ambiente interno do provedor não ocorre porque o isolamento de rede foi burlado, mas por meio de funcionalidades legítimas da plataforma. A rede pode estar bem segmentada, mas um token de conta de serviço IAM com privilégios excessivos, que o invasor conseguiu interceptar (por exemplo, de variáveis de ambiente ou dos metadados), permite chamar legitimamente a API interna por meio do gateway padrão ou do serviço de troca de tokens.
3. Contexto administrativo ou de serviço
O objetivo desse cenário é contornar as restrições técnicas obtendo acesso legítimo por canais destinados aos funcionários. O caminho muitas vezes começa com a exploração do fator humano (phishing, insiders, vazamento de acessos de funcionários ou terceirizados). No entanto, o ponto de entrada final no ambiente interno passa a ser técnico: conexão via VPN do operador, portal de suporte, ferramenta de suporte remoto, estação de trabalho administrativa, certificado SSH ou console serial. Embora o caminho muitas vezes comece com o comprometimento de uma pessoa, a zona inicial resultante (o contexto técnico com determinados privilégios e acesso a recursos em que o pesquisador se encontra) pode coincidir com a do primeiro cenário. Por exemplo, o acesso ao host de um banco de dados gerenciado (DBaaS host) pode ser obtido não pela exploração de uma vulnerabilidade, mas por um canal administrativo legítimo, usado depois para escalonar privilégios.
Entendendo o zoológico arquitetural
Depois de avançar para o interior da infraestrutura da nuvem e obter acesso a um nó, o pentester analisa os artefatos locais. Por trás de um mesmo serviço gerenciado podem se esconder arquiteturas completamente diferentes.
Infraestrutura semelhante ao OpenStack
Nos serviços IaaS baseados em OpenStack, normalmente existe um grande conjunto de componentes: conta de serviço IAM, recursos computacionais, rede, imagens e armazenamento em bloco (block storage), além de processos de API, workers, um broker de mensagens (message broker) e bancos de dados de estado da plataforma. Um serviço gerenciado construído sobre essa camada IaaS pode usar uma máquina virtual separada para cada instância de banco de dados, várias instâncias em uma máquina virtual compartilhada, um cluster Kubernetes em workers virtuais ou até um tenant dedicado para um produto específico.
Embora a presença, por exemplo, do broker de mensagens RabbitMQ seja característica do OpenStack, o simples fato de encontrá-lo ainda não prova que estamos diante de uma instalação clássica do OpenStack. O provedor pode ter alterado o esquema de confiança, adicionado uma API própria e substituído parte dos componentes.
Plataformas com arquitetura Kubernetes
Em nuvens desse tipo, um cluster Kubernetes central controla toda a infraestrutura, não apenas os containers, mas também as máquinas virtuais, outros clusters Kubernetes de clientes e os serviços gerenciados. No nível do ambiente de execução do serviço, o produto pode ser um pod em um namespace compartilhado, uma aplicação dentro de um tenant, uma máquina virtual KubeVirt ou um worker de um cluster separado. Vistas de fora, todas as variantes parecem um único produto, mas suas fronteiras de confiança e a superfície de ataque subsequente diferem radicalmente.
Como o gerenciamento da plataforma é construído com base em um cluster Kubernetes, em que a principal unidade de autorização é o token da conta de serviço, é particularmente importante entender onde está a conta de serviço IAM obtida durante o pentest: no cluster do cliente, no cluster gerenciado ou com o operador que atende vários tenants. Tokens de aparência idêntica podem ter permissões sobre um único pod ou permitir alterar recursos em vários ambientes ao mesmo tempo.
Plano de controle próprio e sistemas de gerenciamento de configuração
O provedor pode abrir mão totalmente de uma solução pronta. Por exemplo, nessa arquitetura a API pública pode ser desenvolvida internamente, as máquinas virtuais podem ser implantadas via libvirt ou uma camada IaaS leve, o gerenciamento de rede pode ser automatizado com scripts em torno do Open vSwitch (OVS), o armazenamento de objetos pode ser construído sobre o Ceph e a configuração dos nós pode ser distribuída via SaltStack ou outro sistema de gerenciamento de configuração.
Nessa arquitetura, o serviço de gerenciamento de máquinas virtuais pode obter configurações de um serviço HTTP interno, o backup pode ser executado por um script com credenciais compartilhadas, o faturamento pode receber eventos de uma fila e o agente interno pode interagir com o plano de controle via mTLS. Quase todos os componentes aqui são específicos do provedor, e a principal zona de risco não está ligada a vulnerabilidades em produtos conhecidos (por exemplo, baseados em soluções de código aberto), mas a erros lógicos nas junções entre os sistemas internos.
Plataforma híbrida
Na prática, o mais comum é uma combinação de abordagens, por exemplo, da seguinte forma:
- O núcleo da infraestrutura (camada IaaS) é construído sobre OpenStack.
- Os serviços gerenciados usam Kubernetes.
- O sistema de armazenamento funciona com base no Ceph.
- O IAM, os sistemas de faturamento e a API interna são implementações próprias.
Listamos a seguir alguns indícios que podem ajudar a formular as primeiras hipóteses sobre o ambiente:
- A presença, no ambiente de execução do host analisado, de um token Kubernetes e do DNS do cluster sugere que o serviço é executado no contexto de um pod;
- O processo qemu-guest-agent em execução indica que estamos dentro de uma máquina virtual, e não em um servidor físico;
- Volumes Ceph/RBD montados indicam a existência, na arquitetura da plataforma, de uma camada de armazenamento separada (storage plane), implementada por meio de armazenamento em bloco distribuído;
- Um grande número de interfaces de rede CNI ou Open vSwitch (OVS) significa que se trata de um nó compartilhado (shared node) do Kubernetes, que pode hospedar containers de outros clientes.
Ainda assim, qualquer um desses indícios precisa de testes de verificação adicionais.
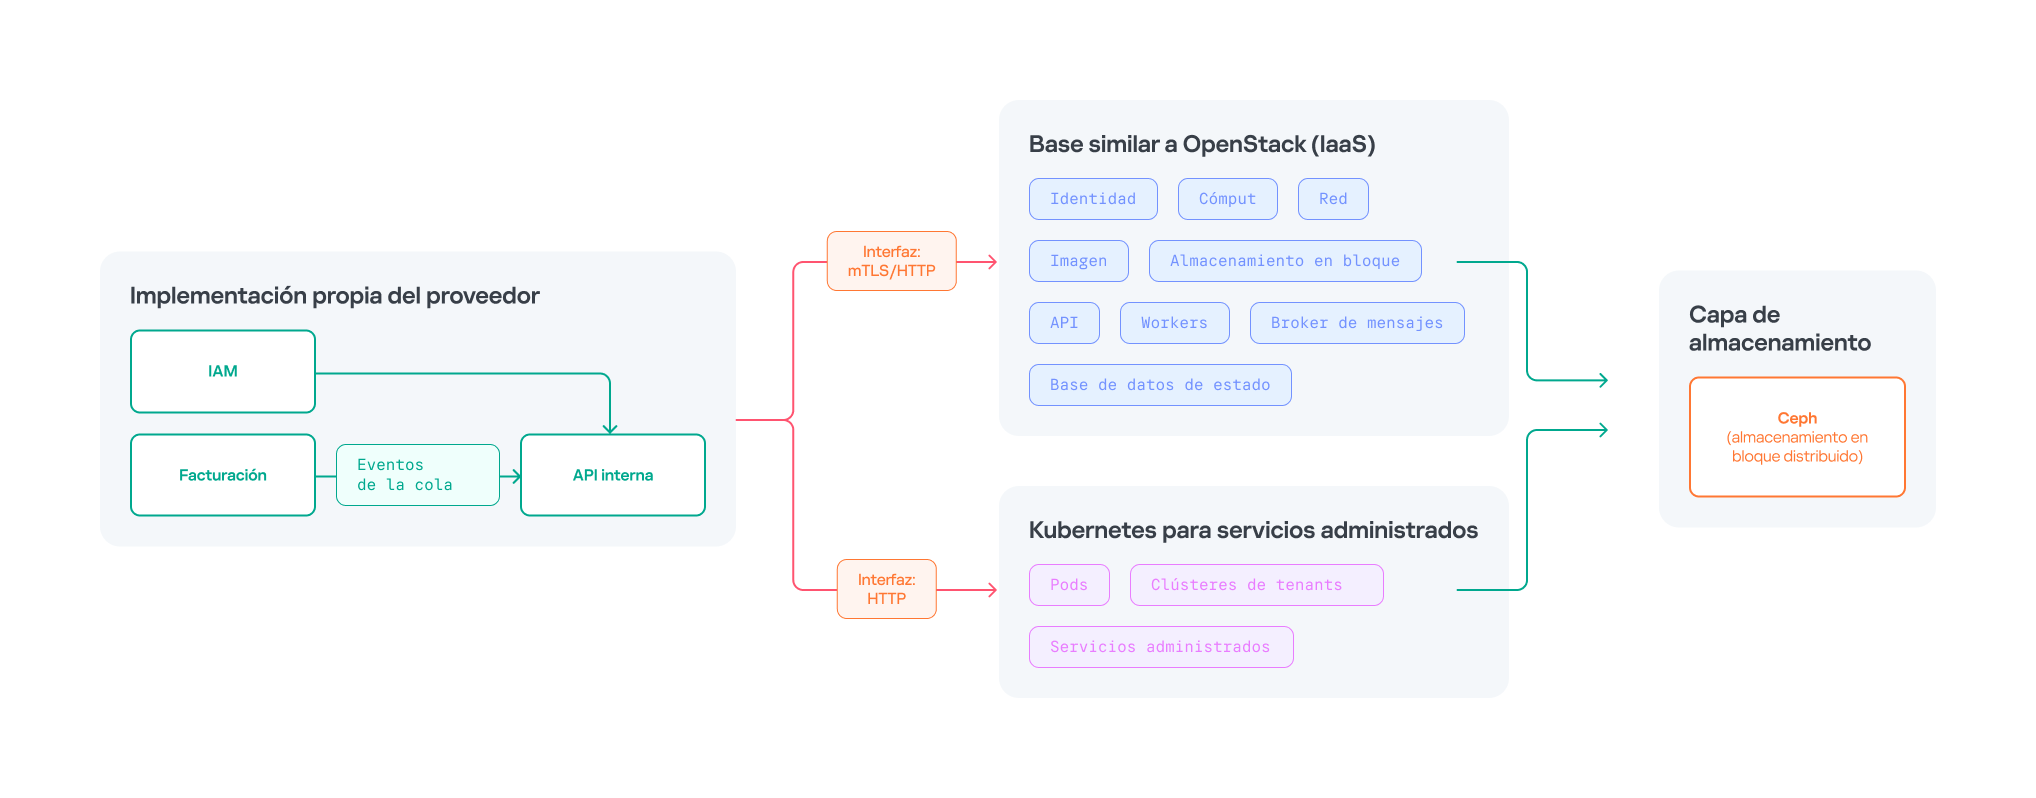
Exemplo de implementação de uma plataforma de nuvem híbrida
Como escolher a próxima fronteira de confiança
Depois que o pentester examina a zona inicial, o caminho seguinte é definido pela combinação de dois fatores:
- Visibilidade de rede: quais segmentos, serviços e tenants são alcançáveis.
- Nível de confiança disponível: quais credenciais, certificados e métodos de API são reconhecidos como válidos nesses segmentos.
Às vezes a rede quase não tem restrições, mas todos os serviços exigem autenticação mTLS correta. Em outro caso, a rede está quase fechada, mas a conta de serviço encontrada pode criar recursos em toda a região por meio da API padrão. Por isso, a acessibilidade de rede (portas abertas) e a conta de serviço IAM devem ser analisadas em conjunto.
Nesse estágio, o pesquisador costuma se concentrar em algumas direções críticas de pesquisa:
Telemetria (observability): verifica-se se os sistemas centralizados de monitoramento (logs, métricas, rastreamentos) coletam dados de diferentes tenants e se há isolamento suficiente entre eles. O risco de comprometimento do isolamento surge quando é possível pesquisar por identificadores de terceiros, ler registros brutos de eventos, extrair credenciais de eventos de telemetria ou influenciar alertas e ações automáticas.
Sistemas de armazenamento e backup de dados: essa camada conecta o ambiente de execução, o plano de gerenciamento (management plane) e os dados do usuário. O pesquisador analisa o escopo das chaves, a vinculação de snapshots e backups aos tenants, os volumes temporários de restauração (restore volumes) e a forma como os workers determinam o proprietário do recurso.
Sistema de faturamento e cotas: verifica-se se a dessincronização entre inventário e contabilização pode levar a computação não faturada, ao contorno de cotas ou ao esgotamento dos recursos do provedor. Aqui, um impacto crítico não exige necessariamente a execução remota de código.
IAM e conta de serviço: o pentester avalia se o token pode abrir caminho por um gateway público ou interno mesmo com segmentação de rede rigorosa. Uma atenção especial é dada ao escopo, à vinculação ao tenant, ao acesso ao cofre de segredos e ao tempo de vida do token.
Cadeia de suprimentos: verificam-se os repositórios de imagens de containers e máquinas virtuais, os repositórios de pacotes de instalação de utilitários e de gerenciadores de pacotes do Kubernetes, bem como as configurações das ferramentas de CI/CD. O acesso de gravação a qualquer um desses componentes às vezes produz um impacto maior do que a execução remota de código em um único nó.
Serviços de gerenciamento: o pesquisador estuda agendadores de tarefas, filas de mensagens, serviços de inventário e sistemas de gerenciamento de configuração. Se for possível obter a confiança de um componente desse tipo, não é mais necessário se conectar diretamente a cada instância do serviço, pois o próprio componente sabe transmitir comandos e alterações a outros recursos.
Cadeias de ataque típicas e incidentes reais
Na prática, os cenários de ataque raramente se repetem, mas alguns exemplos ilustram bem a maneira exata como os invasores transpõem as fronteiras de confiança.
1. Do banco de dados gerenciado aos dados de outros usuários
O pesquisador implanta seu próprio banco de dados gerenciado e usa operadores e procedimentos SQL padrão para compor consultas SQL. No entanto, devido a uma falha no isolamento, a execução de código ultrapassa os limites do ambiente de execução isolado e passa para o ambiente de execução compartilhado do serviço. Ali, encontra-se um token de conta de serviço IAM não vinculado a uma instância específica do banco de dados gerenciado. O comprometimento do isolamento é confirmado pela manipulação bem-sucedida do banco de dados de outro tenant (de teste).
Neste caso, a possibilidade de executar consultas SQL em si não era uma vulnerabilidade. A transição crítica ocorreu entre o contexto do tenant e a conta de serviço IAM compartilhada. O resultado do ataque foi um impacto entre tenants, que nem sequer exigiu obter privilégios root no host.
Uma lógica semelhante foi demonstrada no caso público ChaosDB. O recurso Jupyter Notebook no Azure Cosmos DB criava o risco de acesso às chaves de outros clientes. Esse exemplo é importante porque a vulnerabilidade em uma função de usuário específica de um serviço gerenciado afetou outros componentes da plataforma.
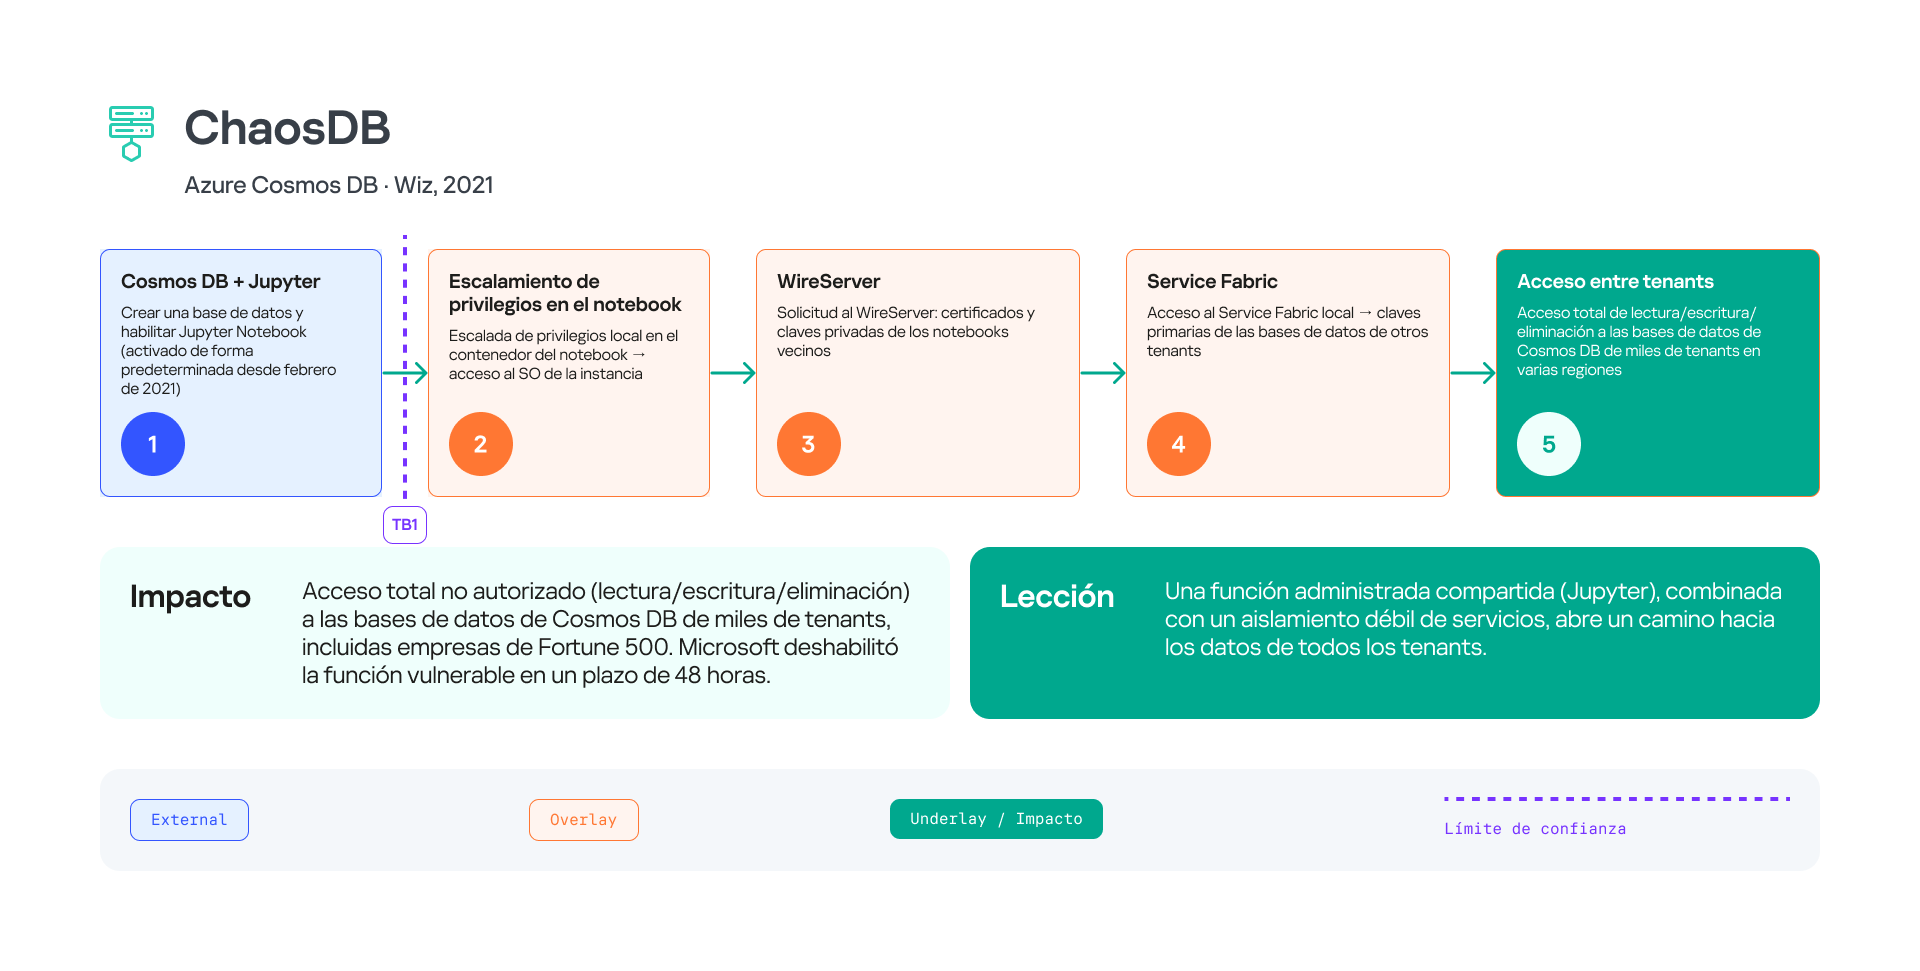
2. Do pod do Kubernetes aos dados de outros usuários
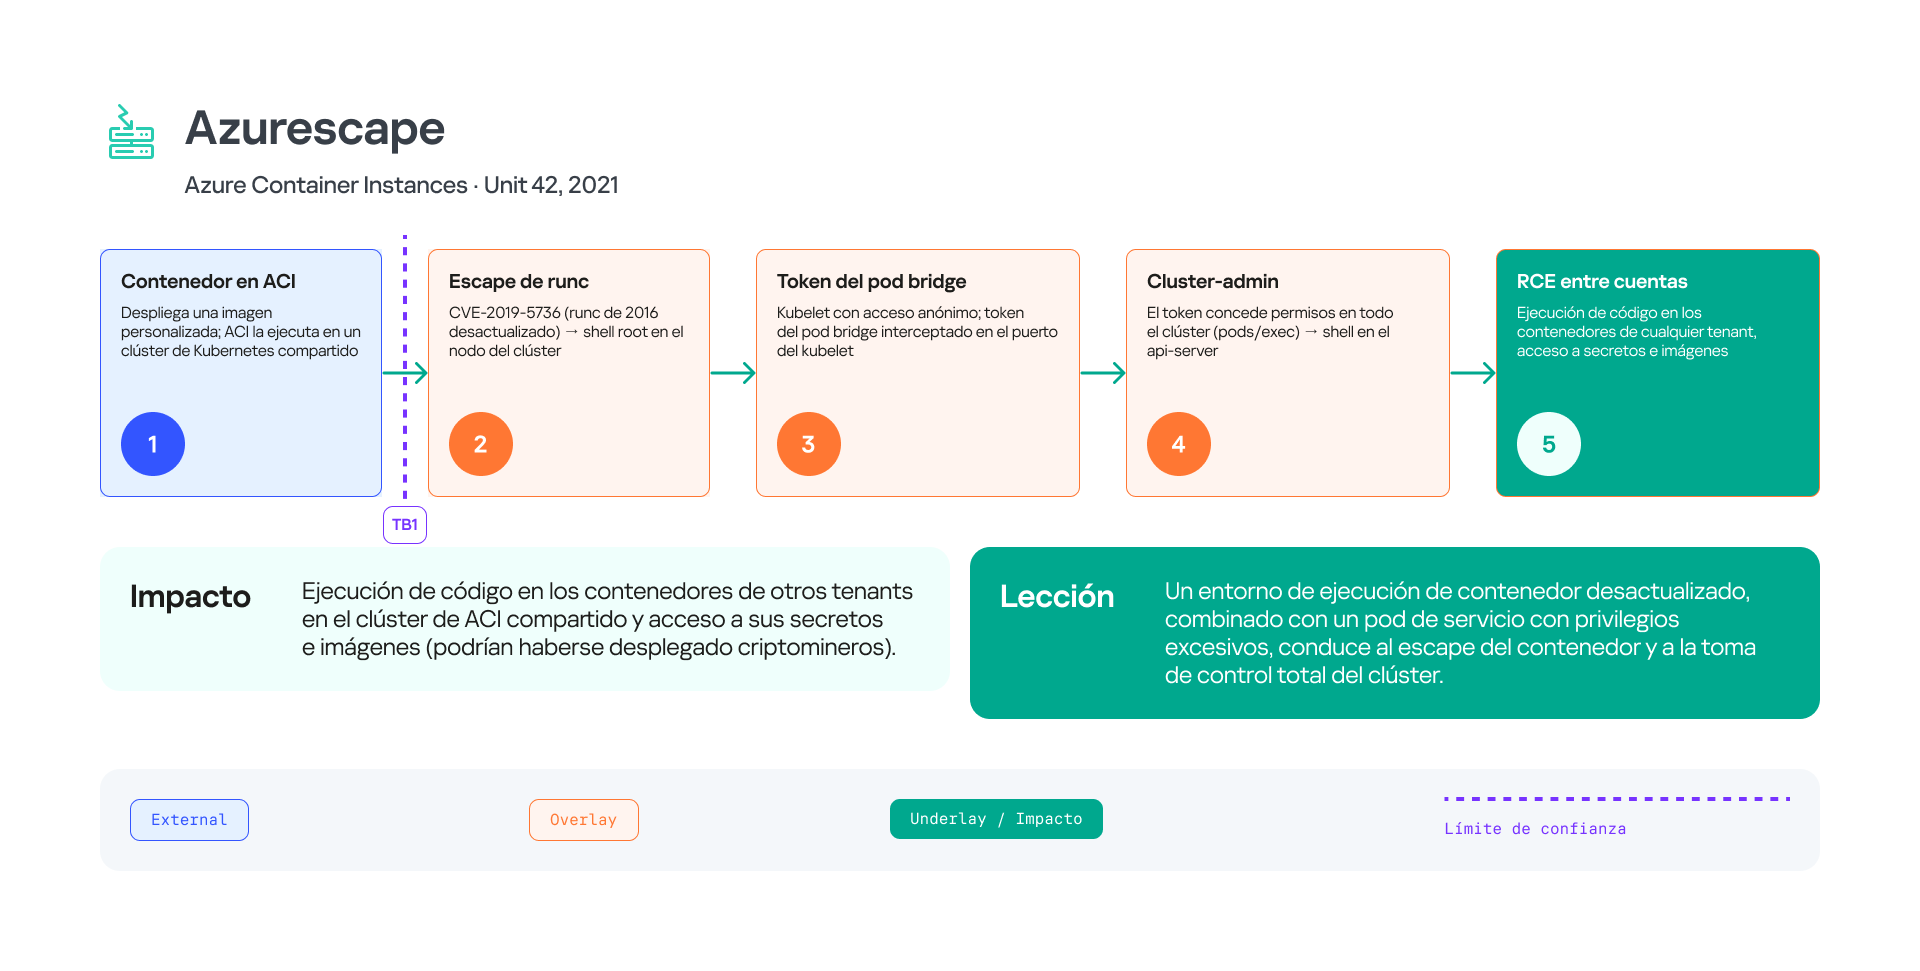
O pentester executa seu próprio container e, explorando uma vulnerabilidade de isolamento, assume o controle do host subjacente. No host, encontra-se uma conta de serviço privilegiada do Kubernetes que processa solicitações da API do cluster de gerenciamento. Uma ação controlada sobre um pod vizinho, pertencente ao segundo tenant de teste, confirma o comprometimento do isolamento.
Foi exatamente assim que funcionou a cadeia Azurescape, publicada pela Unit 42: escape do container, obtenção de uma conta de serviço IAM privilegiada e comprometimento de um cluster Kubernetes multitenant. O principal aqui não foi o escape do container, mas a possibilidade de obter um token de conta de serviço válido para outros tenants.
3. De uma operação pública à alteração de recursos internos da nuvem
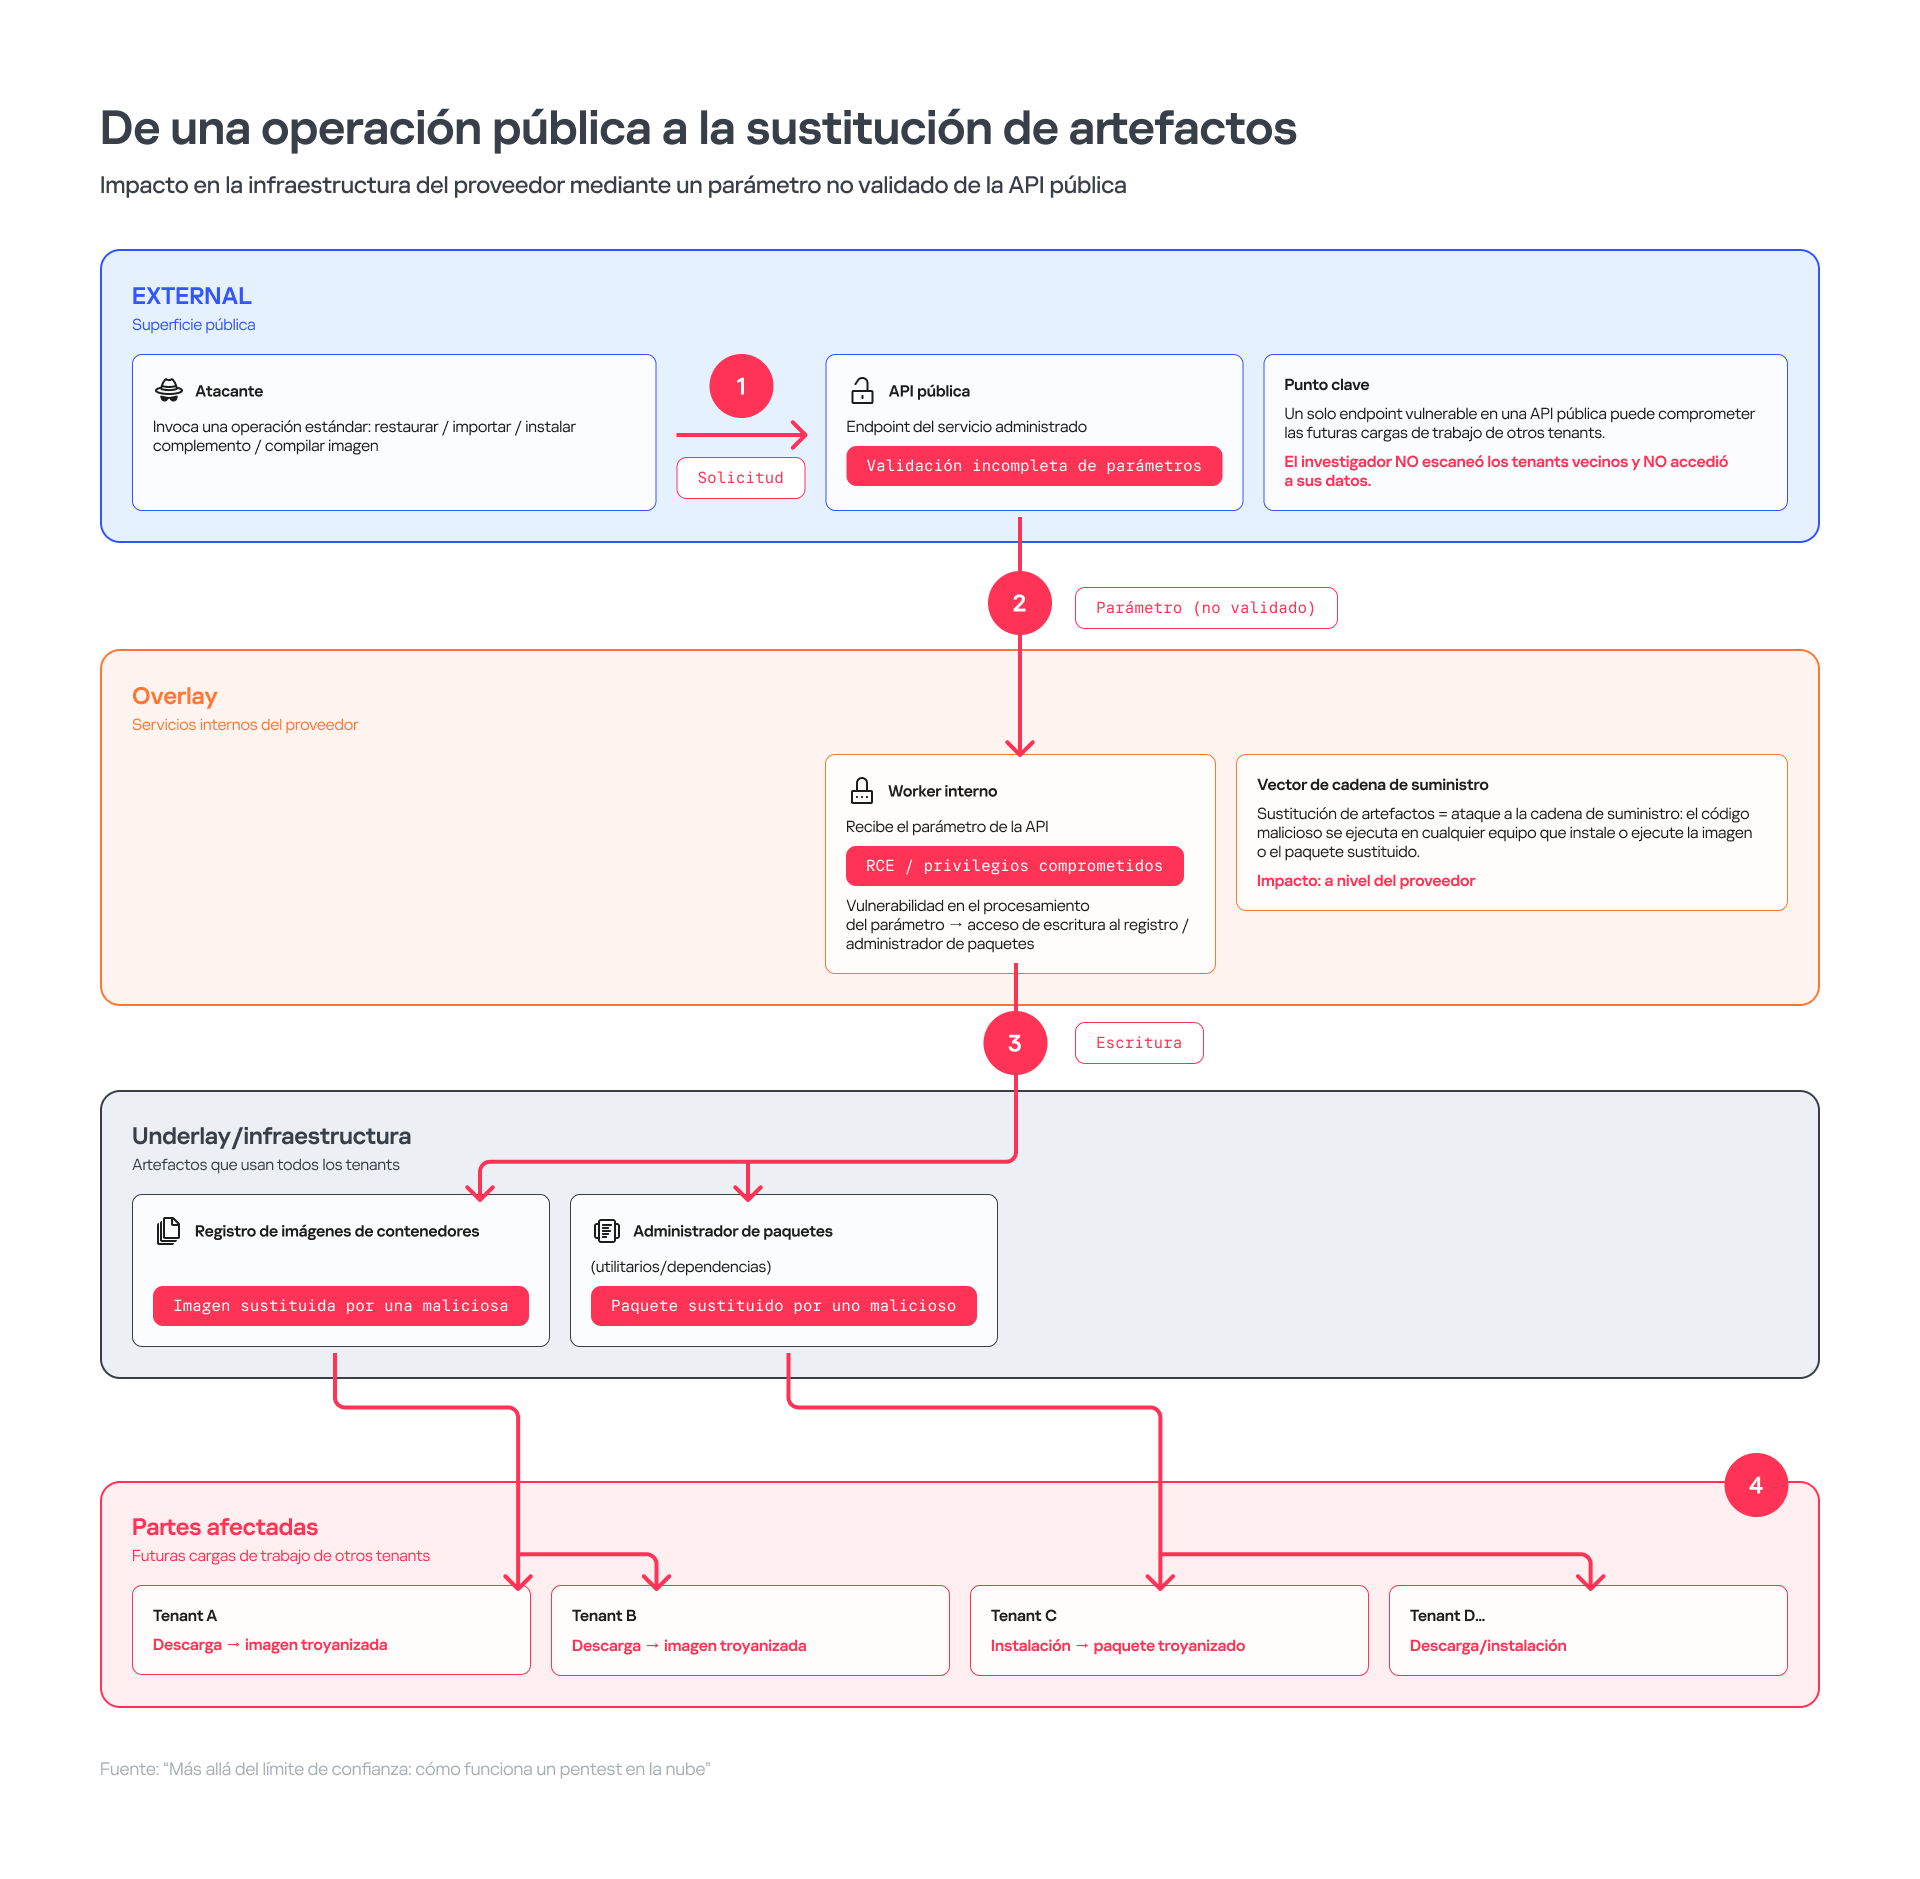
O usuário chama uma operação padrão de restauração, importação, instalação de plugin ou build de imagem para algum serviço gerenciado. A API pública não valida com rigor suficiente o parâmetro repassado ao worker interno. A exploração de uma vulnerabilidade no próprio worker leva à execução remota de código ou ao comprometimento de permissões (obtenção de acesso de gravação ao registro de imagens de containers ou ao gerenciador de pacotes), o que permite substituir o artefato de destino por um artefato próprio.
Este é um exemplo de impacto no nível da infraestrutura do provedor de nuvem. Um endpoint (worker) da API pública é capaz de comprometer futuras cargas de trabalho de outros clientes, mesmo que o pesquisador não tenha feito varredura nos tenants vizinhos nem acessado os dados deles.
4. Escape da máquina virtual
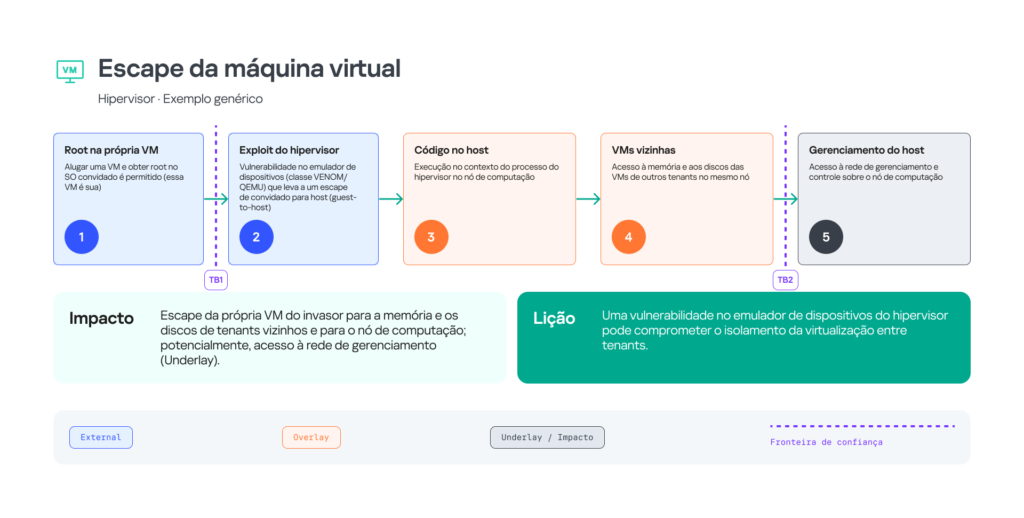
O ponto de partida da pesquisa é a própria máquina virtual do pentester na nuvem. A descoberta de uma vulnerabilidade no sistema de virtualização permite executar o vetor guest-to-host (“convidado para host”) e rodar código arbitrário na máquina host do próprio hipervisor. Em seguida, o pesquisador passa do host do hipervisor para a rede de gerenciamento ou o plano de controle, o que é considerado a transposição da próxima fronteira de confiança.
Pesquisas públicas mostram que o escape de sistemas de virtualização é uma classe real de ameaças. Na maioria das vezes, ele está ligado a erros nos mecanismos de compartilhamento de memória e a vulnerabilidades em buffers de troca compartilhados ou em pastas compartilhadas. Ainda assim, a existência de uma CVE pública não prova a vulnerabilidade de uma nuvem específica. Para o sucesso do ataque, também importam a versão do hipervisor, a configuração e a presença de camadas de proteção adicionais (por exemplo, políticas rígidas no nível do sistema operacional). Testar técnicas “convidado para host” em uma infraestrutura pública compartilhada envolve alto risco de impacto destrutivo sobre o próprio hipervisor e suas máquinas virtuais; por isso, esse teste é estritamente regulamentado e realizado apenas mediante acordo com o provedor.
O que considerar resultado do pentest
O valor de um teste de invasão de ambientes de nuvem não é determinado pela quantidade de portas encontradas nem pelo fato de executar comandos remotos, mas pela transposição comprovada das fronteiras de confiança. Nossa prática mostra que, com base nos resultados do pentest, os provedores de nuvem esperam respostas para as seguintes perguntas críticas:
- um invasor em um tenant consegue ler, alterar ou excluir dados de outros clientes?
- é possível, com código do usuário, interceptar o token da conta de serviço IAM do provedor ou executar ações em nome dela?
- o comprometimento de um ambiente de execução leva à propagação do ataque para outros recursos, serviços, a célula ou a região?
- é viável afetar os recursos tecnológicos internos do provedor a partir de segmentos com baixo nível de confiança (por exemplo, diretamente de uma máquina virtual do cliente)?
- é possível passar do ambiente virtual para o host, o hipervisor, o sistema de armazenamento ou a rede física, e qual é a escala real do impacto destrutivo?
Para cada vetor de ataque confirmado, registram-se as condições iniciais, as observações, as explicações alternativas, a prova minimamente suficiente, as limitações e o dano potencial. Um resultado negativo também é importante. Ele mostra qual fronteira de confiança se baseia em suposições cegas e qual se baseia em mecanismos de controle capazes de resistir, na prática, a tentativas direcionadas de contorno.
Confirmação segura do impacto
Verificar o ambiente interno do provedor e a camada de infraestrutura difere de testar uma aplicação externa comum sobretudo pelo custo de um erro. Qualquer ação descuidada pode provocar um efeito cascata e afetar uma fila de mensagens compartilhada, um cluster de gerenciamento, os backups de vários clientes ou um host compartilhado.
Antes de iniciar o trabalho, as regras de engajamento (Rules of Engagement) devem definir:
- as contas, os tenants, as regiões e os componentes de infraestrutura permitidos;
- as técnicas de ataque permitidas e os limites de intensidade de carga;
- as janelas de tempo para os testes, os canais de comunicação operacional e as condições para interrupção imediata do trabalho;
- as regras de tratamento de contas bloqueadas, credenciais e informações confidenciais descobertas por acaso;
- o procedimento para verificar hipóteses que extrapolem o escopo inicial da pesquisa.
Reiteramos que é mais seguro confirmar o impacto entre tenants em um segundo tenant controlado pela equipe de pentest, com dados sintéticos preparados previamente. O impacto no nível do provedor é verificado em um recurso ou artefato de teste dedicado, criado especialmente para isso. A observação passiva é preferível à leitura de dados de terceiros, e uma ação mínima reversível é preferível a uma exploração ampla.
É importante distinguir dois formatos de trabalho. O proprietário do tenant pode testar os próprios recursos dentro das regras de cada nuvem, mas isso nem sempre lhe dá o direito de pesquisar a infraestrutura do provedor. O pentest do ambiente interno do provedor e da camada de infraestrutura exige uma autorização específica do proprietário da plataforma.
Conclusão
A principal tarefa de uma plataforma de nuvem não é apenas alocar recursos rapidamente, mas isolar os clientes uns dos outros com segurança e delegar o gerenciamento à automação do provedor. O pentest externo clássico mostra apenas a possibilidade de invasão pela superfície de ataque pública. No entanto, a confiabilidade real da própria nuvem depende de que as barreiras de proteção resistam a ataques nas fronteiras de confiança entre os seguintes perímetros da plataforma:
- External (camada externa): superfície de ataque pública, que inclui APIs públicas, painéis de gerenciamento, serviços IAM, endpoints de interação com serviços de TI e SDKs. Aqui, o pentest avalia a possibilidade de obter acesso inicial ao ambiente do cliente (tenant) e de comprometer contas.
- Overlay (serviços de TI): camada virtual do lado do cliente, onde funcionam os ambientes de execução (runtime), sistemas operacionais, SGBDs e agentes de serviço. As verificações aqui visam burlar o isolamento do runtime e encontrar privilégios excessivos de contas de serviço IAM. Lembramos que introduzimos também uma segunda camada Overlay, pois o ambiente de execução do serviço do cliente e a infraestrutura interna do provedor têm fronteiras de confiança e pontos de entrada diferentes. Falamos dela a seguir.
- Overlay (componentes do provedor): ambiente lógico interno da nuvem. Inclui os sistemas de faturamento, backup, monitoramento, controle de acesso e as APIs internas. Os ataques nessa camada visam transpor as fronteiras entre serviços/tenants e encontrar formas de interação não autorizada com o plano de controle.
- Underlay (camada de infraestrutura): a base da plataforma. Inclui os sistemas operacionais de host, sistemas de virtualização (hipervisores), a rede de transporte, os sistemas de armazenamento de dados, os controladores de gerenciamento de hardware (BMC) e outros mecanismos de baixo nível. O objetivo das verificações é avaliar o isolamento da virtualização e a escala real do impacto sobre as cargas de trabalho vizinhas.
É por isso que um pentest de nuvem eficaz se estrutura como uma sequência de transições verificáveis entre essas zonas. A cada passo, o pesquisador registra o ponto de partida, descreve o novo contexto obtido, analisa suas cadeias de confiança e executa a ação mínima necessária para confirmar a transposição da próxima fronteira de confiança.
É justamente essa abordagem sistemática que permite transformar achados técnicos isolados em um risco mensurável e comprovado para um usuário, um serviço ou toda a plataforma de nuvem.
O que vem no próximo artigo
Este material traça os contornos gerais da abordagem descrita, ou seja, quais níveis existem na nuvem e por onde exatamente passam as fronteiras de confiança entre eles. No segundo artigo, analisaremos em detalhe a camada externa da nuvem e o pentest de serviços gerenciados do lado do cliente.


Sumário
- Pontos-chave
- Principais termos
- O que o pentester precisa verificar
- A plataforma de nuvem como objeto de pesquisa
- A analogia do hotel e os três níveis da nuvem
- Por onde passam as fronteiras de confiança
- Modelo de invasor e três objetivos da pesquisa
- Entendendo o zoológico arquitetural
- Como escolher a próxima fronteira de confiança
- Cadeias de ataque típicas e incidentes reais
- O que considerar resultado do pentest
- Confirmação segura do impacto
- Conclusão
- O que vem no próximo artigo
Dos mesmos autores

Na mesma categoria
Além da fronteira de confiança: como funciona o pentest de nuvem