
Autores
A proteção dos sistemas de informação em uma organização moderna depende de um conjunto de tecnologias que geram milhares de alertas de segurança todos os dias. Ao analisar esse volume de alertas, é possível notar que uma parcela significativa corresponde a falsos positivos. O ideal é filtrar esses alertas automaticamente, para que o analista possa se concentrar apenas naqueles que podem indicar um incidente real. No entanto, elaborar filtros também é uma tarefa trabalhosa. Para criar um filtro correto, o analista precisa:
- examinar os logs;
- identificar a origem da atividade;
- definir os limites da filtragem;
- escolher os critérios de filtragem;
- escrever a regra;
- verificar a robustez do filtro.
Neste artigo, analisamos como automatizar a criação dos filtros em si, a fim de reduzir a carga de trabalho do analista.
Critérios de validade dos filtros
No contexto dos alertas de segurança, um filtro é uma combinação de valores de campos do evento que indica que a detecção é um falso positivo e não requer a atenção do analista. É possível gerar filtros para quaisquer combinações de campos do evento, mas nem todas as combinações resultam em um filtro válido. Por isso, é preciso definir critérios de validade, ou seja, parâmetros que permitam verificar se um filtro específico realmente elimina o ruído informacional e não bloqueia alertas úteis.
Em geral, as regras de detecção nos sistemas de segurança contêm um conjunto de condições, e cada uma delas pode gerar um alerta. Um evento específico aciona uma determinada parte da regra de detecção. Chamamos de contexto o conjunto de eventos aos quais essa parte da regra responde. Um bom filtro deve, sempre que possível, cobrir o contexto completo e, ao mesmo tempo, não ultrapassar seus limites. Filtros muito amplos ou muito restritos serão ineficazes. Por exemplo, um filtro baseado no PowerShell descartará eventos demais, inclusive aqueles que exigem a atenção do analista. Além disso, a maioria dos eventos filtrados não terá relação com a regra de detecção específica. Já um filtro por um ID específico cobrirá apenas um evento, que talvez nunca volte a ocorrer.
Problemas que surgem na geração de filtros
Ao criar filtros, podemos nos deparar com vários problemas. Em primeiro lugar, os eventos costumam conter um número excessivo de campos (cerca de 400, em média), e a maioria deles não é necessária para a filtragem. Além disso, gerar combinações desses campos e classificá-las por relevância é uma tarefa bastante trabalhosa. Por isso, o primeiro passo é descartar os campos que não nos interessam e manter apenas aqueles que fazem sentido usar no filtro. Assim, dos 400 campos de um evento, quatro podem bastar para a filtragem.
Outro problema é a normalização de strings. Os valores dos campos (por exemplo, o caminho para o mesmo aplicativo em sistemas diferentes) podem variar de acordo com as configurações de cada sistema, os nomes das pastas de usuário etc. Para que o filtro leve em conta todas essas variações, é necessário normalizar as strings. Em particular, nos caminhos de arquivos, é possível substituir a letra da unidade de disco e as pastas de usuário por variáveis de ambiente padronizadas e uniformizar a capitalização de todos os caminhos.
Por fim, se o filtro reproduz integralmente a consulta da regra de detecção, na prática ele desativa essa regra. Esse problema pode ser resolvido removendo do filtro os campos do evento usados na regra de detecção. Por exemplo, se a regra é acionada pelo caminho de um arquivo, é possível filtrar os alertas indesejados de duas maneiras:
- Usar no filtro campos diferentes do caminho do arquivo;
- Usar no filtro um fragmento do caminho do arquivo que não seja usado na regra. Por exemplo, para a regra
file_path: ".../something.exe", é possível configurar um filtro que exclua os eventos cujo caminho de arquivo contenha o diretóriouser/unique_files/.
Filtragem de alertas de segurança com algoritmo
Diante dos problemas descritos, a geração automática de filtros para alertas de segurança deve seguir estes passos:
- O analista recebe um alerta de segurança, avalia que é um falso positivo e recorre ao gerador de filtros.
- O gerador recebe o evento do alerta (composto por 400 campos) e a regra acionada por ele. A partir deles, determina o contexto.
- O gerador seleciona os campos relevantes para o filtro.
- O gerador normaliza as strings.
- O gerador forma diferentes combinações dos campos selecionados. Para isso, usamos o algoritmo FP-Growth (frequent pattern growth) sobre o contexto definido anteriormente. O FP-Growth constrói, sobre um conjunto de dados (no nosso caso, o contexto), uma árvore de itens frequentes (campos), descartando os que aparecem com pouca frequência. Isso reduz o número de combinações que precisam ser testadas e, assim, diminui o custo de selecionar as mais relevantes.
- O gerador classifica as combinações obtidas por relevância e apresenta as três mais bem classificadas para que o analista escolha.
Por exemplo, vejamos um evento descrito pelo seguinte JSON:
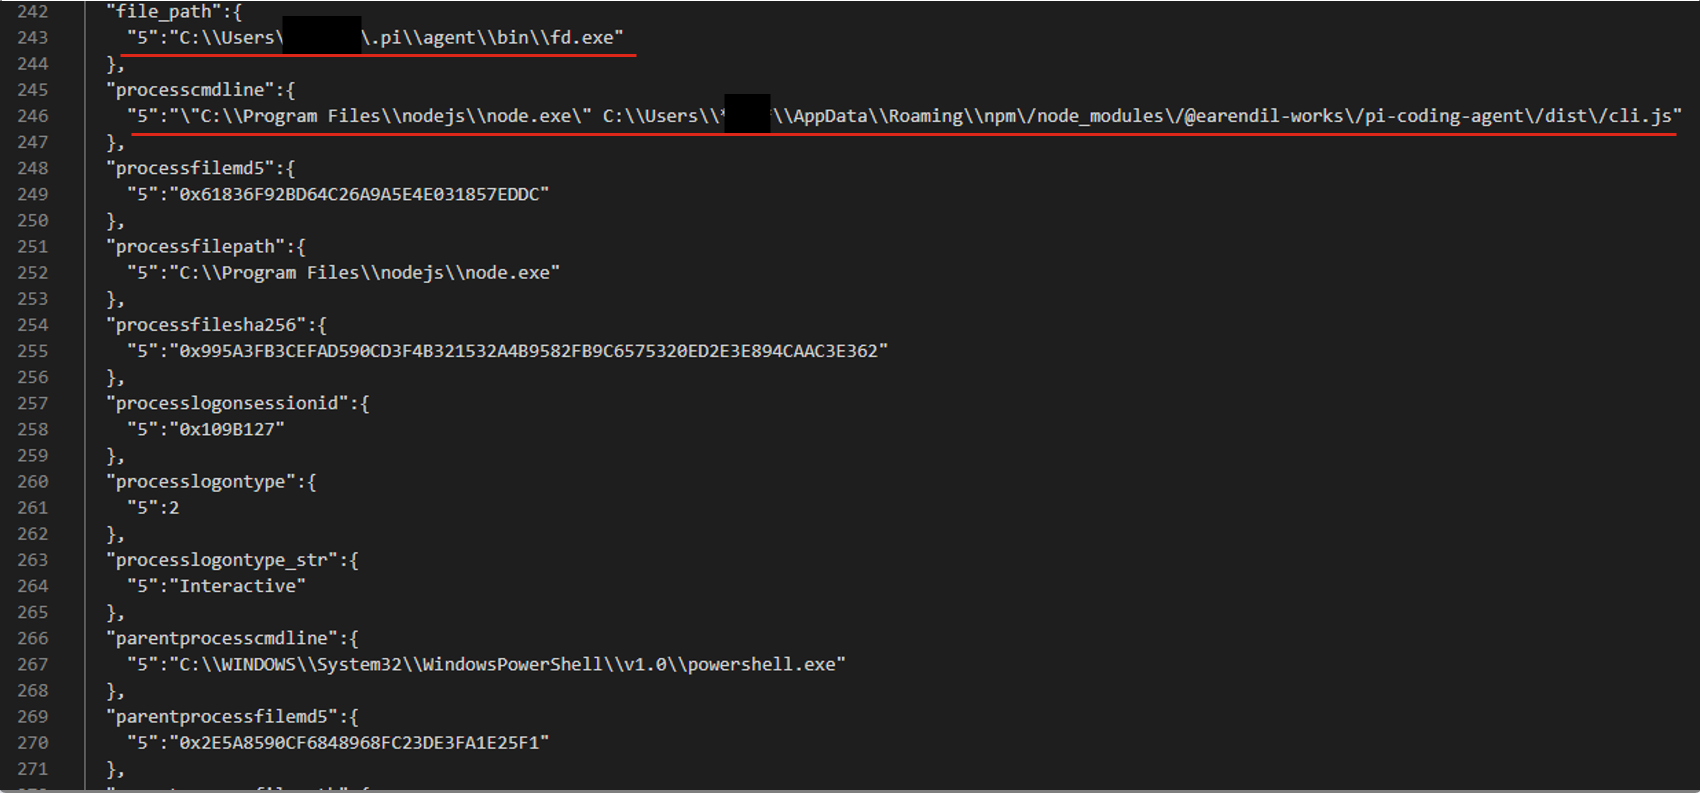
Após a geração e a classificação das combinações, obtivemos três filtros baseados em caminhos de arquivos:
-
1processcmdline:("nodejs\\node.exe" AND "****\\appdata\\roaming\\npm\/node_modules\/pi-coding-agent\/dist\/cli.js")
-
1file_path:"****/.pi\\agent\\bin\\fd.exe"
-
1processcmdline: "programfiles\\nodejs\\node.exe"
O último filtro se mostrou amplo demais, mas o analista considerou os outros dois válidos.
Vantagens e desvantagens da abordagem descrita para a geração de filtros
A abordagem algorítmica para a geração de filtros tem várias vantagens. Em primeiro lugar, ela é bastante simples e determinística, ou seja, o resultado para um alerta específico é reproduzido a cada geração. Em segundo lugar, ela é interpretável, ou seja, permite entender por que uma combinação específica ficou entre as primeiras na classificação e por que um campo específico nem chegou à lista de campos candidatos. Em terceiro lugar, os estágios deste processo são independentes entre si. Assim, é possível melhorar e ajustar cada um deles isoladamente, sem receio de comprometer o funcionamento do algoritmo em outro ponto. Por fim, ela não tem dependências externas nem modelos, por isso é fácil de implantar em qualquer ambiente do cliente.
No entanto, também há desvantagens. A principal é a dependência do contexto. Se, por algum motivo, não há contexto, não é possível criar o filtro. Isso ocorre, por exemplo, quando a regra é acionada por um evento pela primeira vez. O segundo problema é a normalização de strings. Há grande probabilidade de surgirem casos atípicos que as regras de normalização não cobrem e que, muitas vezes, nem podem ser descritos corretamente, pois se contradizem entre si.
Esses problemas podem ser resolvidos com LLMs. Se os filtros são gerados por um LLM, não há necessidade de contexto, pois o LLM não enumera nem classifica combinações. Além disso, ele permite lidar com a normalização de strings com mais flexibilidade e considerar inclusive casos atípicos. Ao mesmo tempo, não é obrigatório usar o LLM em todos os estágios da geração. Decidimos manter a solução algorítmica onde ela funciona bem. Por exemplo, um algoritmo simples executa o estágio de seleção dos campos adequados sem erros, por isso não delegamos essa tarefa ao modelo.
Geração de filtros com LLMs
O processo de geração de filtros com o uso de LLMs é o seguinte:
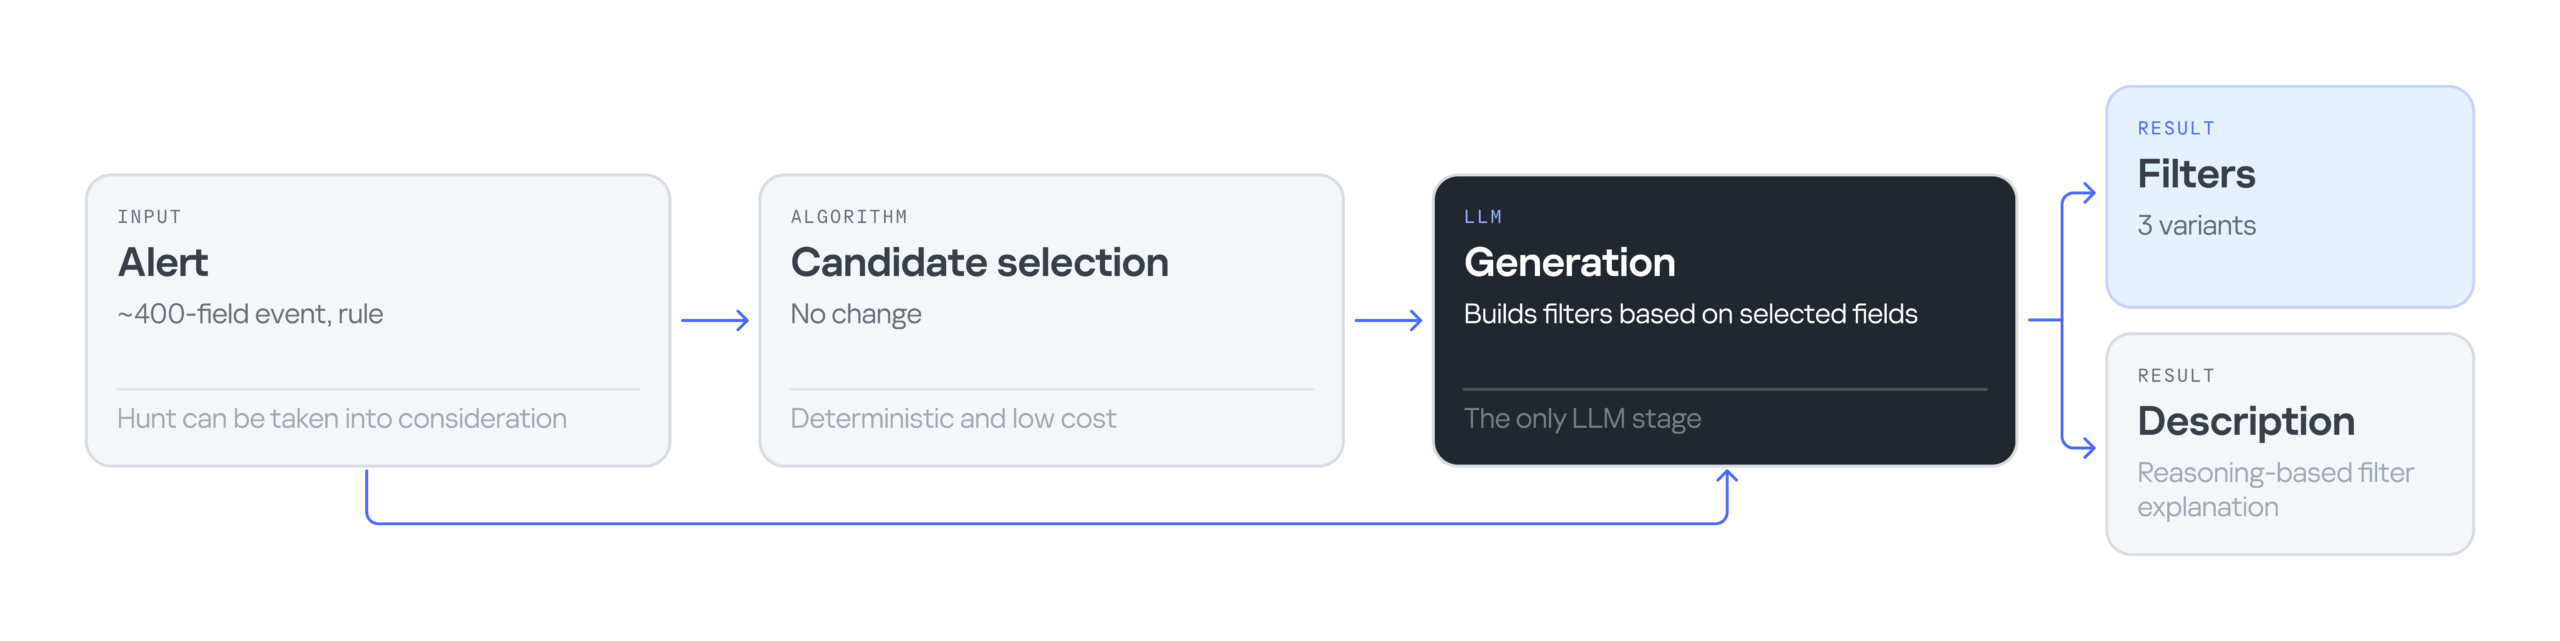
A entrada continua sendo um alerta (que contém um evento com 400 campos) e a regra acionada por ele. Em seguida, usamos o algoritmo para selecionar os campos mais adequados para o filtro. Depois, o LLM processa as informações de entrada (o evento, os campos selecionados e a regra de detecção) e gera três opções de filtro, acompanhadas de uma explicação. A explicação ajuda o analista a entender por que esses filtros específicos foram propostos e a fazer uma escolha fundamentada.
Vejamos o seguinte evento em formato JSON:
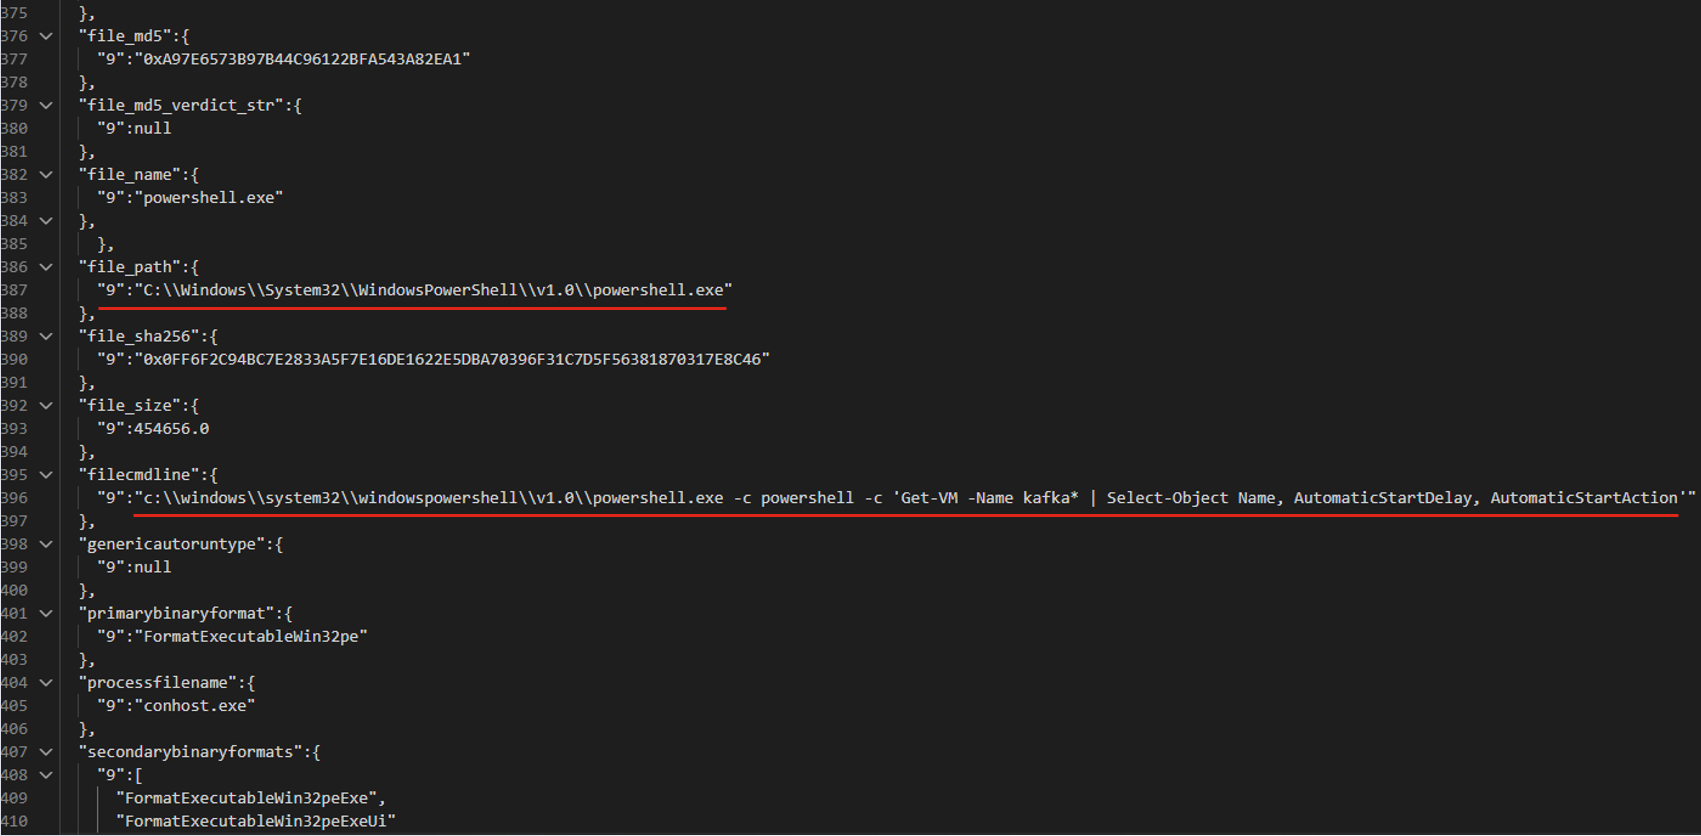
O LLM propôs três opções de filtro que contêm uma linha de comando em comum:
-
1file_path: "\\WindowsPowerShell\\powershell.exe" AND filecmdline: "Get-VM -Name kafka\*"
-
1filecmdline: "Get-VM -Name kafka\*"
-
1filecmdline: "kafka*"
Como no exemplo anterior, dos três filtros gerados, dois eram válidos. O último se mostrou amplo demais para ser usado. O analista escolheu o primeiro filtro e fez um pequeno ajuste antes de usá-lo:
|
1 |
file_path: "powershell.exe" AND filecmdline: "Get-VM -Name kafka\*" |
Vantagens e desvantagens da abordagem de geração de filtros com LLMs
O uso de LLMs resolveu os problemas da geração puramente algorítmica de filtros, ou seja, a dependência do contexto e os erros na normalização de strings. No entanto, a opção com uma única solicitação ao modelo também tinha desvantagens. Por um lado, ela não previa a validação dos dados de saída. O LLM retornava os filtros sem verificação de sintaxe nem mecanismo de correção de erros. Por outro lado, ao contrário da versão algorítmica, todas as tarefas de geração de filtros eram implementadas com um único prompt de sistema. Como consequência, uma pequena correção em um ponto pode comprometer a lógica em outro.
Uso de múltiplos agentes de IA
Para resolver os problemas que surgem ao usar um único modelo com um único prompt de sistema na geração de filtros, experimentamos distribuir as tarefas entre vários agentes de LLM. Nesta versão, passamos a usar agentes já no estágio de seleção dos campos relevantes. No total, a cadeia conta com quatro agentes:
- Seletor: seleciona os campos necessários;
- Gerador: gera os filtros;
- Validador: avalia os filtros gerados. Se os filtros forem considerados inválidos, devolve a tarefa ao gerador. Se os campos selecionados forem considerados irrelevantes, inicia um novo ciclo de seleção de campos. Se os filtros passarem na validação ou o limite de tentativas de regeneração se esgotar, os filtros válidos ou os melhores obtidos são encaminhados ao analista;
- Comentarista: analisa os filtros gerados e explica quais valores dos campos foram usados e por quê.
Para o evento a seguir, em formato JSON, os agentes produzem três filtros válidos baseados no caminho do arquivo.
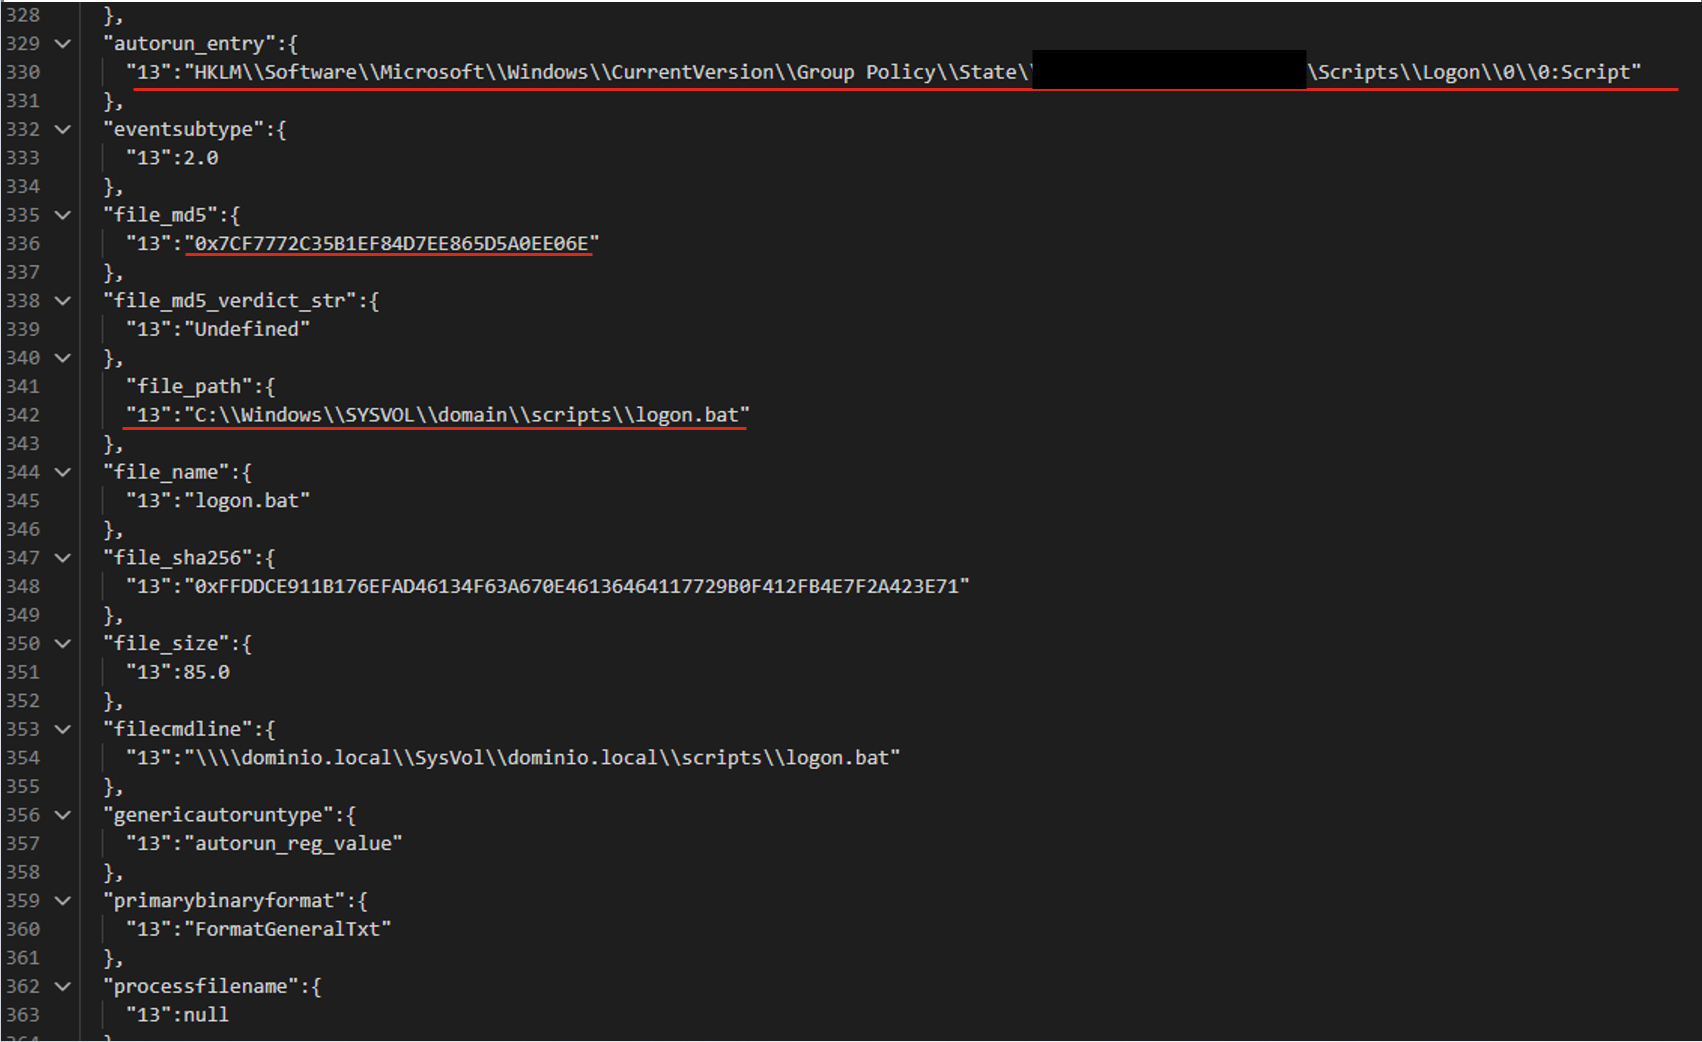
Os filtros se diferenciam entre si por parâmetros adicionais que reforçam a detecção:
-
1file_path:"sysvol\\domain\\scripts\\logon.bat"
-
1file_path:"sysvol\\domain\\scripts\\logon.bat" AND file_md5:"0x7..6E"
-
1autorun_entry: "Group Policy\\State" AND file_path: "SYSVOL\\domain\\scripts\\logon.bat"
Vantagens e desvantagens da abordagem com agentes
Com agentes de LLM, obtemos um sistema capaz de validar e corrigir filtros. Sua arquitetura modular permite ajustar e aprimorar os diferentes estágios da geração de forma independente. Por outro lado, o maior número de chamadas ao LLM em comparação com as abordagens anteriores torna o sistema mais lento. Além disso, ele depende da disponibilidade do modelo, que pode não estar presente no ambiente isolado da organização.
Avaliação do sistema de geração de filtros
Para avaliar a eficácia do sistema de geração de filtros, usamos duas métricas principais:
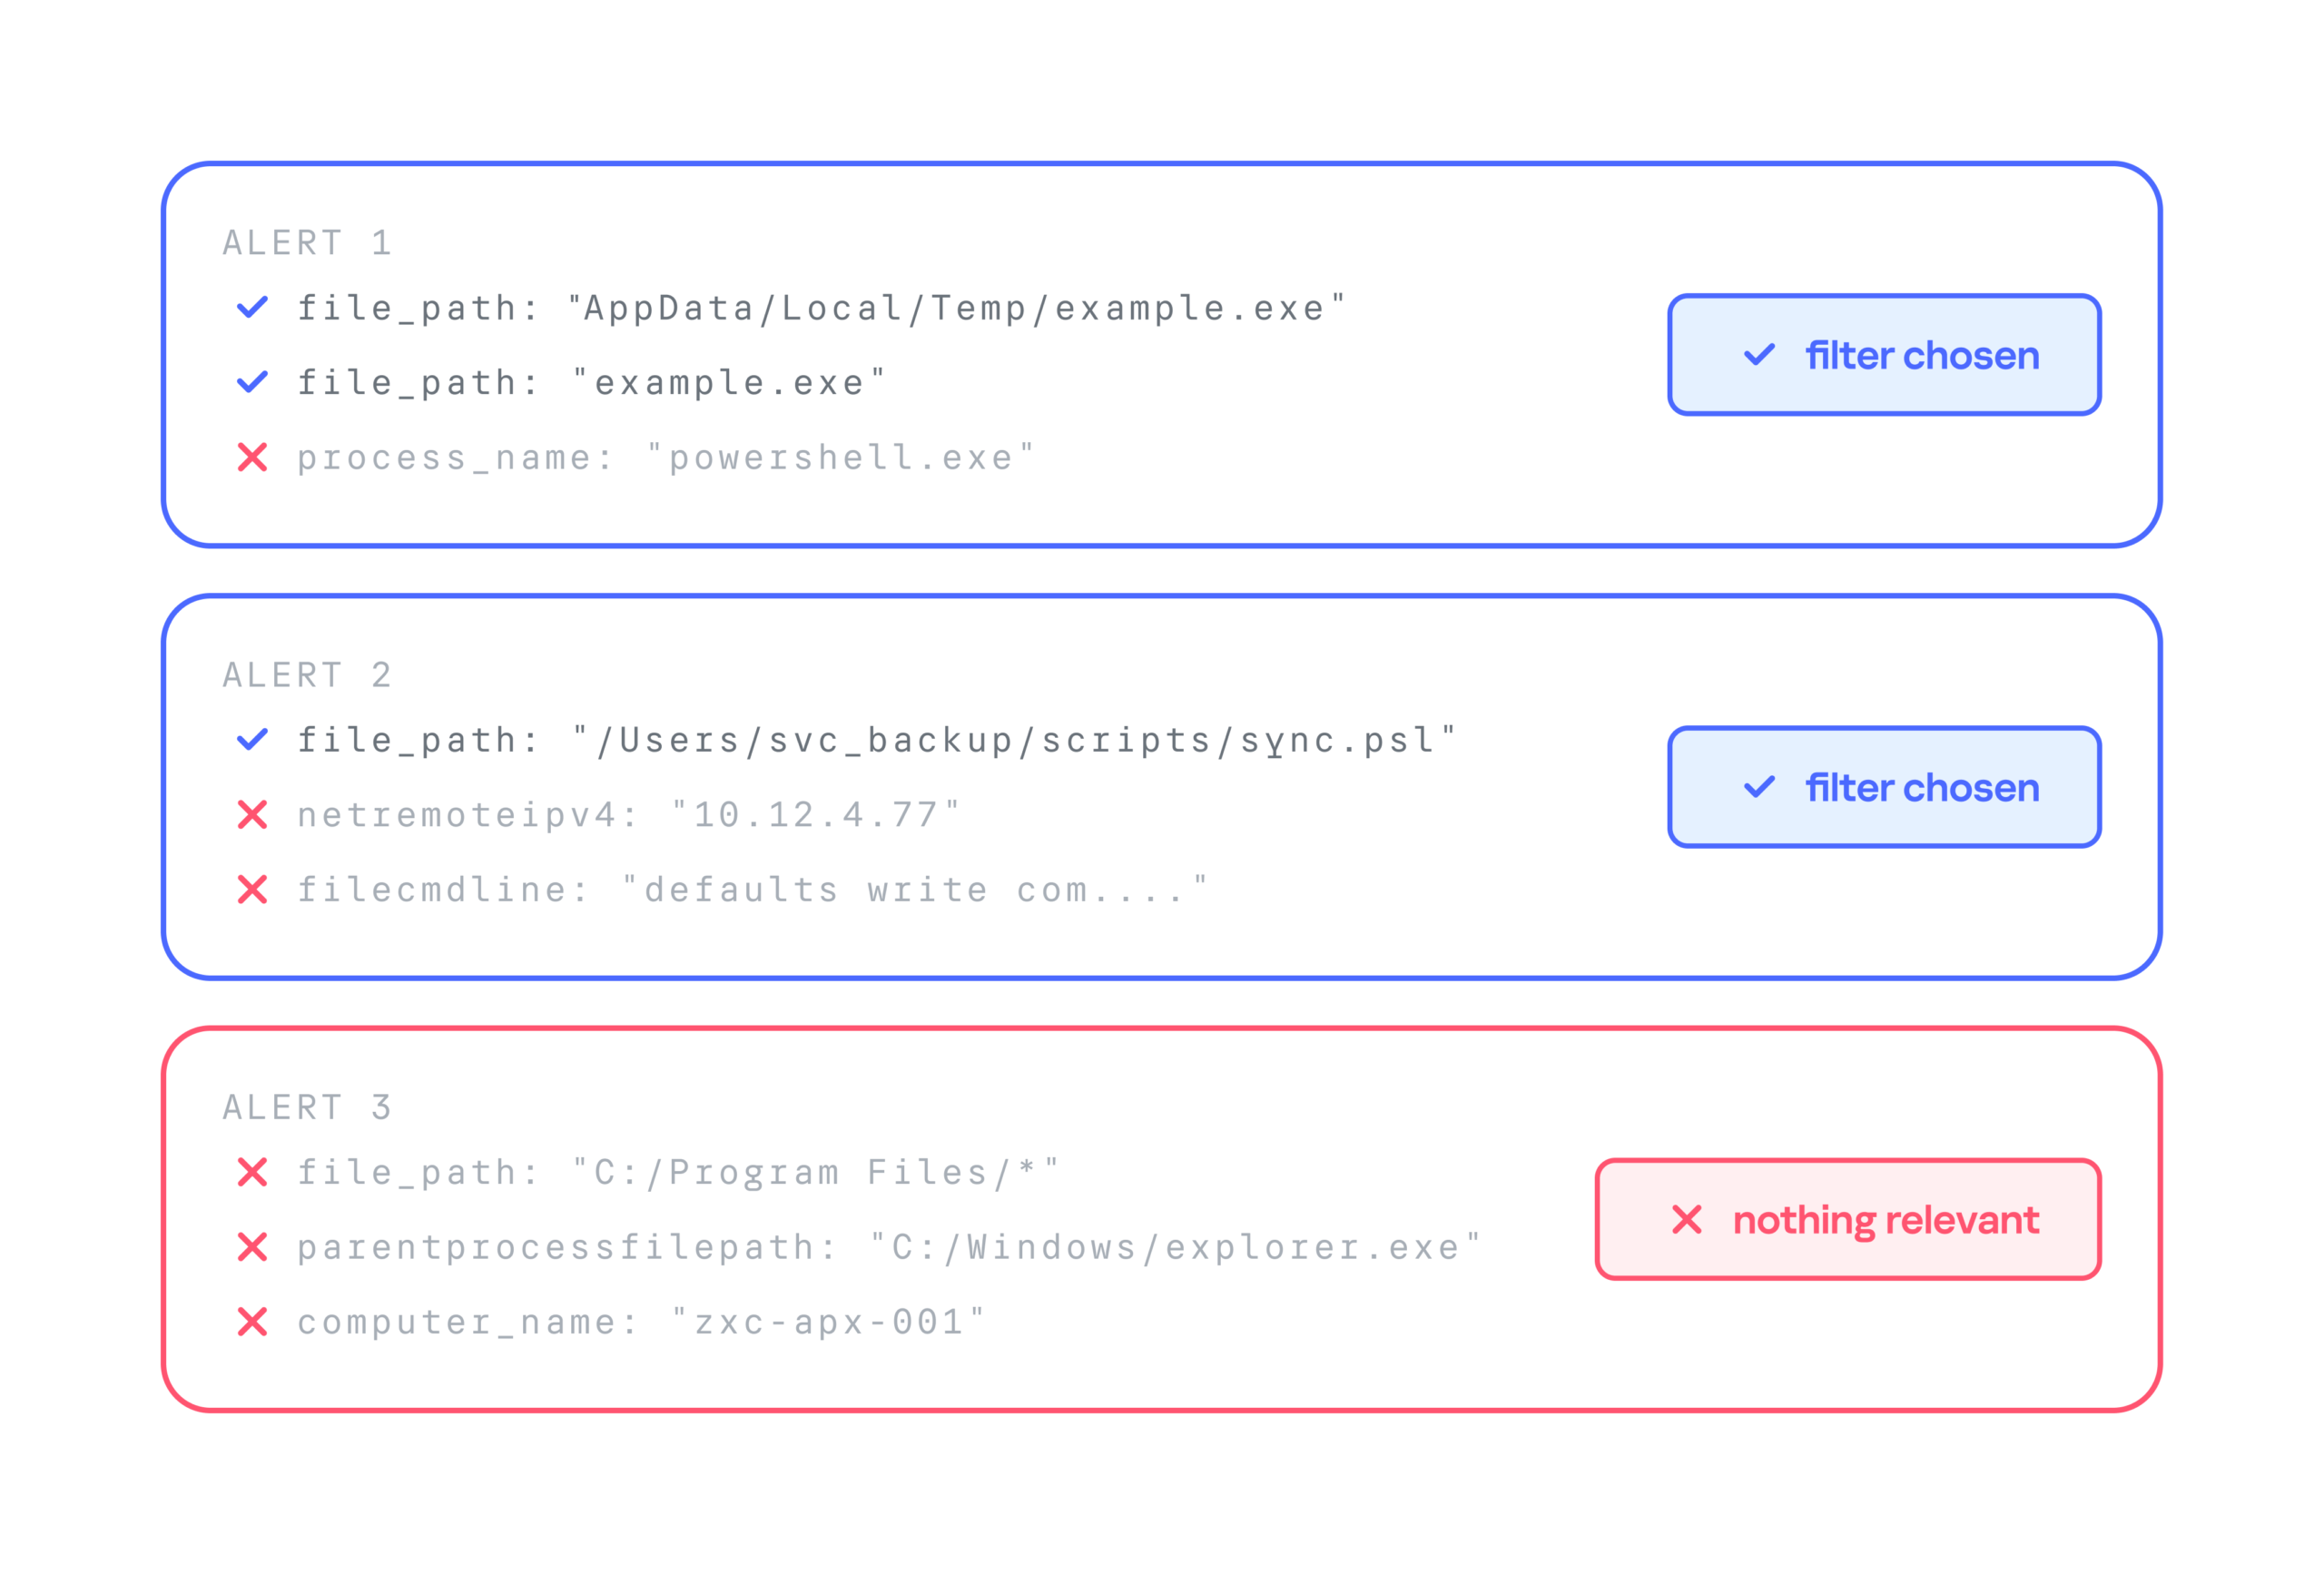
- Taxa de aprovação (Approval Rate). Para cada alerta de segurança, o sistema propõe três filtros. Se o analista escolher pelo menos um deles, consideramos a geração bem-sucedida. Assim, no exemplo abaixo, a taxa de aprovação é de dois terços.
- Taxa de redução de falsos positivos (FP drop). Avaliamos em que medida o filtro ajuda a reduzir o número de falsos positivos. Essa métrica só pode ser avaliada após algum tempo, pois é necessário comparar o número de alertas falsos positivos recebidos em um determinado período antes e depois da implantação do filtro.
A seguir, apresentamos uma avaliação comparativa dos três sistemas de geração de filtros com base nessas métricas:
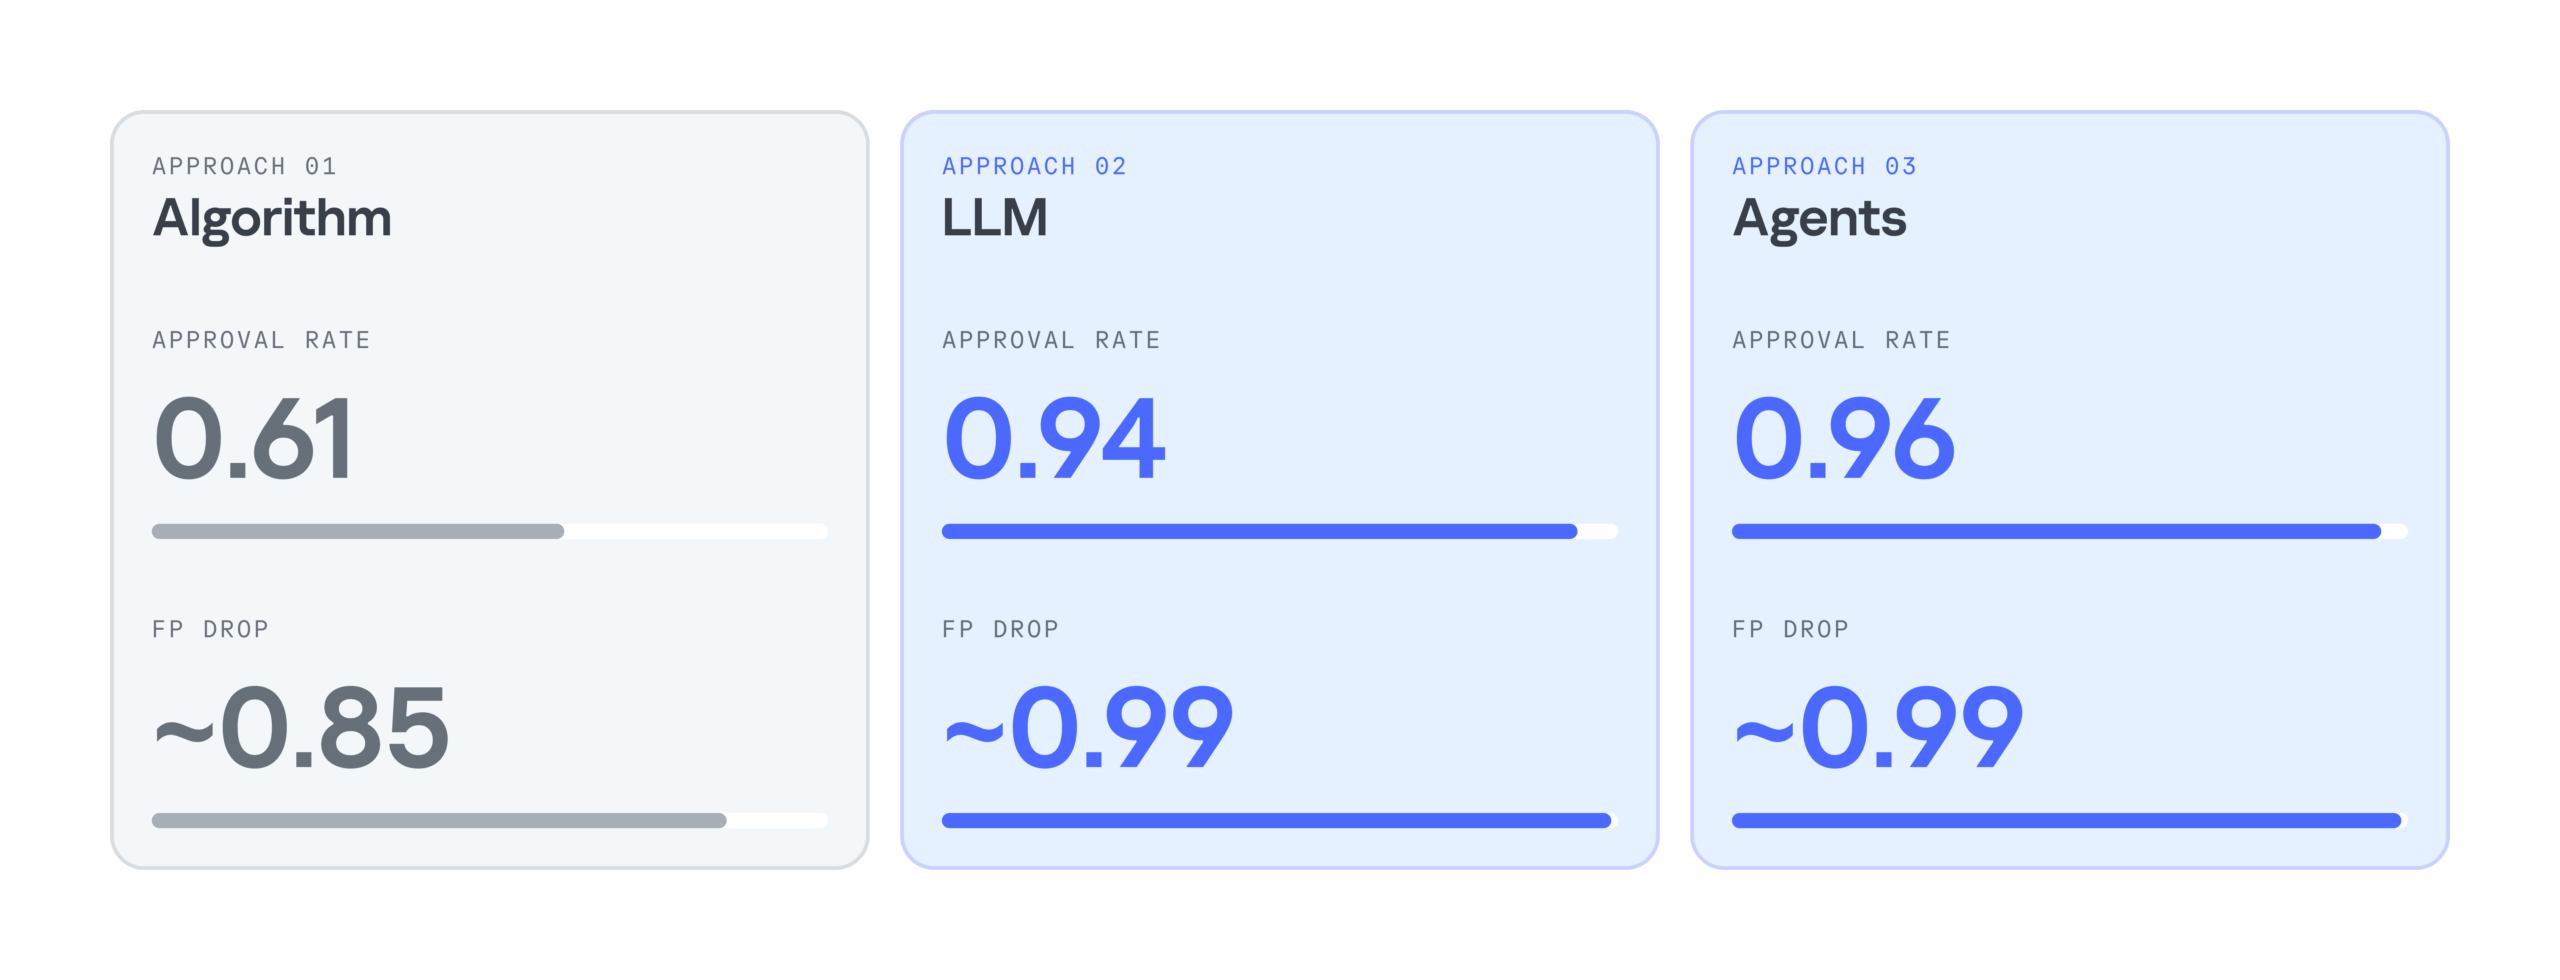
Podemos observar que os LLMs aumentam significativamente a eficácia da geração de filtros. Ao mesmo tempo, a eficácia do uso de LLMs sem agentes e a da abordagem com agentes praticamente não diferem. Por isso, decidimos adotar a opção mais simples e rápida, que usa um LLM com um único prompt de sistema. Com isso, reduzimos em 99% o número de falsos positivos, aumentamos em 28% o número de filtros gerados por dia e melhoramos em 17% a eficiência do trabalho dos analistas com os alertas.
Conclusão
Como demonstrado na prática, a geração de filtros pode ser automatizada com eficácia. Analisamos diferentes abordagens para a geração automatizada de filtros para falsos positivos em alertas de segurança: uma exclusivamente algorítmica, uma baseada em LLM e outra que emprega múltiplos agentes de IA. Todas são capazes de gerar filtros válidos e simplificam significativamente o trabalho do analista, mas cada uma tem suas próprias vantagens e desvantagens.
Com a abordagem algorítmica, obtivemos valores mais baixos nas métricas de avaliação, mas, em dois terços dos casos, ela permite gerar filtros que atendem às necessidades do analista. Essa abordagem apresenta resultados particularmente bons em situações em que já existe um conjunto de eventos semelhantes a serem filtrados (ou seja, quando há contexto suficiente acumulado). Além disso, o gerador algorítmico pode ser implantado em qualquer ambiente. As abordagens baseadas em LLM e em múltiplos agentes de LLM apresentam alto nível de precisão e desempenho semelhante. Por isso, a abordagem com agentes, por ser mais lenta, mostra-se desnecessária neste estágio. Quando há acesso a um LLM, a opção mais adequada parece ser usar um único modelo para implementar vários estágios do ciclo de geração.


Sumário
- Critérios de validade dos filtros
- Problemas que surgem na geração de filtros
- Filtragem de alertas de segurança com algoritmo
- Vantagens e desvantagens da abordagem descrita para a geração de filtros
- Geração de filtros com LLMs
- Vantagens e desvantagens da abordagem de geração de filtros com LLMs
- Uso de múltiplos agentes de IA
- Vantagens e desvantagens da abordagem com agentes
- Avaliação do sistema de geração de filtros
- Conclusão
Na mesma categoria
Geração de filtros na prática: dos algoritmos aos LLMs